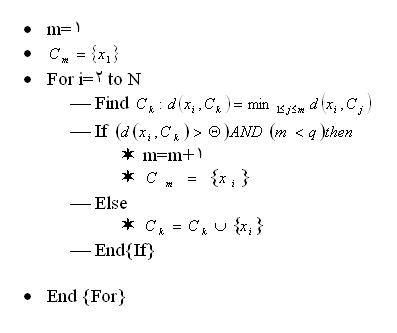اصول گزيده اي از کامپيوترهاي کوانتومي

اصول گزيده اي از کامپيوترهاي کوانتومي

خلاصه

فيزيك كوانتومي مهم ترين دستاورد علم بشري در توصيف طبيعت است. اين نظريه كه در سالهاي 27-1925 توسط «ورنر هايزنبرگ»، «اروين شرودينگر»، «پل ديراك»، «ماكس پلانك» و چند تن ديگر پايه گذاري شد، اساس تمام ادراك امروزي ما از عالم است. به بيان دقيق تر، مكانيك كوانتومي مجموعه اي از قوانين، روابط رياضي و مفاهيم فلسفي است كه توصيف كننده رفتار ذرات بنيادين تشكيل دهنده عالم است. البته با تعميم همين قوانين و روابط، مي توان رفتار تمام سيستم هاي فيزيكي اي كه پيش از آن بررسي شده بودند را نيز بررسي و تعيين كرد.


اصول گزيده اي از کامپيوترهاي کوانتومي


         روياي محاسبات ماشيني يا ماشيني كه بتواند مسائل را در اشكال گوناگون حل كند كمتر از دو قرن است كه زندگي بشر را به طور جدي در بر گرفته است. اگر از ابزارهايي نظير چرتكه و برخي تلاشهاي پراكنده ديگر در اين زمينه بگذريم، شايد بهترين شروع را بتوان به تلاشهاي «چارلز بابيج» و « بلز پاسكال» با ماشين محاسبه مكانيكي شان نسبت داد. با گذشت زمان و تا ابتداي قرن بيستم تلاشهاي زيادي جهت بهبود ماشين محاسب مكانيكي صورت گرفت كه همه آنها بر پايه رياضيات دهدهي (decimal) بود، يعني اين ماشين ها محاسبات را همان طور كه ما روي كاغذ انجام مي دهيم انجام مي دادند. اما تحول بزرگ در محاسبات ماشيني در ابتداي قرن بيستم شروع شد. اين زماني است كه الگوريتم و مفهوم فرايندهاي الگوريتمي (algorithmic processes) به سرعت در رياضيات و بتدريج ساير علوم رشد كرد. رياضيدانان شروع به معرفي سيستم هاي جديدي براي پياده سازي الگوريتمي كلي كردند كه در نتيجه آن، سيستم هاي انتزاعي محاسباتي بوجود آمدند. در اين ميان سهم برخي بيشتر از سايرين بود.

         آنچه امروزه آنرا دانش كامپيوتر و يا الكترونيك ديجيتال مي ناميم مرهون و مديون كار رياضيدان برجسته انگليسي و يكي از غولهاي انديشه قرن بيستم به نام «آلن تورينگ» (Alan Turing) است. وي مدلي رياضي را ابداع كرد كه آنرا ماشين تورينگ مي ناميم و اساس تكنولوژي ديجيتال در تمام سطوح آن است. وي با پيشنهاد استفاده از سيستم دودويي براي محاسبات به جاي سيستم عدد نويسي دهدهي كه تا آن زمان در ماشين هاي مكانيكي مرسوم بود، انقلابي عظيم را در اين زمينه بوجود آورد. پس از نظريه طلايي تورينگ، ديري نپاييد كه «جان فون نويمان» يكي ديگر از نظريه پردازان بزرگ قرن بيستم موفق شد ماشين محاسبه گري را بر پايه طرح تورينگ و با استفاده از قطعات و مدارات الكترونيكي ابتدايي بسازد. به اين ترتيب دانش كامپيوتر بتدريج از رياضيات جدا شد و امروزه خود زمينه اي مستقل و در تعامل با ساير علوم به شمار مي رود. گيتهاي پيشرفته، مدارات ابر مجتمع، منابع ذخيره و بازيابي بسيار حجيم و كوچك، افزايش تعداد عمل در واحد زمان و غيره از مهم ترين اين پيشرفتها در بخش سخت افزاري محسوب مي شوند. در 1965 «گوردون مور» اظهار كرد كه توان كامپيوترها هر دو سال دو برابر خواهد شد. در تمام الين سالها، تلاش عمده در جهت افزايش قدرت و سرعت عملياتي در كنار كوچك سازي زير ساختها و اجزاي بنيادي بوده است. نظريه مور در دهه هاي 60 و 70 ميلادي تقريبا درست بود. اما از ابتداي دهه 80 ميلادي و با سرعت گرفتن اين پيشرفتها، شبهات و پرسش هايي در محافل علمي مطرح شد كه اين كوچك سازي ها تا كجا مي توانند ادامه پيدا كنند؟ كوچك كردن ترازيستورها و مجتمع كردن آنها در فضاي كمتر نمي تواند تا ابد ادامه داشته باشد زيرا در حدود ابعاد نانو متري اثرات كوانتومي از قبيل تونل زني الكتروني بروز مي كنند. گرچه هميشه تكنولوژي چندين گام بزرگ از نظريه عقب است، بسياري از دانشمندان در زمينه هاي مختلف به فكر رفع اين مشكل تا زمان رشد فن آوري به حد مورد نظر افتادند. به اين ترتيب بود كه براي نخستين بار در سال 1982 «ريچارد فاينمن» معلم بزرگ فيزيك و برنده جايزه نوبل، پيشنهاد كرد كه بايد محاسبات را از دنياي ديجيتال وارد دنياي جديدي به نام كوانتوم كرد كه بسيار متفاوت از قبلي است و نه تنها مشكلات گذشته و محدوديت هاي موجود را بر طرف مي سازد، بلكه افق هاي جديدي را نيز به اين مجموعه اضافه مي كند. اين پيشنهاد تا اوايل دهه 90 ميلادي مورد توجه جدي قرار نگرفت تا بالاخره در 1994 «پيتر شور» از آزمايشگاه AT&T در آمريكا نخستين گام را براي محقق كردن اين آرزو برداشت. به اين ترتيب ارتباط نويني بين نظريه اطلاعات و مكانيك كوانتومي شروع به شكل گيري كرد كه امروز آنرا محاسبات كوانتومي يا محاسبات نانو متري (nano computing) مي ناميم. در واقع هدف محاسبات كوانتومي يافتن روشهايي براي طراحي مجدد ادوات شناخته شده محاسبات ( مانند گيت ها و ترانزيستورها ) به گونه ايست كه بتوانند تحت اثرات كوانتومي، كه در محدوده ابعاد نانو متري و كوچكتر بروز مي كنند، كار كنند. به نمودار صفحه بعد دقت كنيد.

         در اين شكل به طور شماتيك و در سمت چپ يك مدار نيم جمع كننده را مشاهده مي كنيد كه معادل كوانتومي و نانو متري آن در سمت راست پيشنهاد شده است. نوع اتم هاي به كار رفته، نحوه چينش اتم ها، چگونگي ايجاد سلول نمايش يافته ( معماري سلولي ) و چند ويژگي ديگر خصوصيات معادل با گيت هاي به كار رفته در نمونه ديجيتال هستند. يك راه نظري براي پياده سازي سلول در اين طرح، استفاده از «نقاط كوانتومي» (quantum dots) يا چيزي است كه در زبان مكانيك كوانتومي آنرا «اتم مصنوعي » مي ناميم.


         ورود به دنياي محاسبات كوانتومي نيازمند دو پيش زمينه مهم است. نخست بايد اصول اساسي و برخي تعابير مهم فلسفي مكانيك كوانتومي را به طور دقيق بررسي كرد. سپس مفهوم اطلاعات در فيزيك نيز، چه به صورت كلاسيك و چه در معناي جديد كوانتومي آن بايد درك شود.


Quantum Mechanics


         فيزيك كوانتومي مهم ترين دستاورد علم بشري در توصيف طبيعت است. اين نظريه كه در سالهاي 27-1925 توسط «ورنر هايزنبرگ»، «اروين شرودينگر»، «پل ديراك»، «ماكس پلانك» و چند تن ديگر پايه گذاري شد، اساس تمام ادراك امروزي ما از عالم است. به بيان دقيق تر، مكانيك كوانتومي مجموعه اي از قوانين، روابط رياضي و مفاهيم فلسفي است كه توصيف كننده رفتار ذرات بنيادين تشكيل دهنده عالم است. البته با تعميم همين قوانين و روابط، مي توان رفتار تمام سيستم هاي فيزيكي اي كه پيش از آن بررسي شده بودند را نيز بررسي و تعيين كرد. پايه رياضي اين نظريه جبر خطي عالي است. مفاهيمي از قبيل فضاي هيلبرت ، ماتريس ها، عملگرها، ويژه توابع و ويژه مقادير و تيديلات از مهم ترين موارد مي باشند. در حيطه فيزيك نظريه نيز مباحثي همچون تابع موج، سيستم و تحول آن، فضاي حالت، اندازه گيريها و مكانيك آماري مورد بررسي قرار مي گيرند. همچنين در سطوح بسيار پيشرفته تر و پيشروي اين نظريه عناويني همچون مفهوم و كاربرد اسپين، نظريه اندازه گيري، متغيرهاي پنهان، مساله ناجايگزيدگي، نيروي كوانتومي و ميدان راهنما، پارادوكس EPR  و قضيه بل مطرح مي شوند.

         معرفي مكانيك كوانتومي به عنوان يك ساختمان كاري فيزيكي جديد در ابتداي قرن بيستم منجر به تحولي عظيم در ساختار  چند هزار ساله انديشه بشري شد. مكانيك كوانتومي در ابتداي ظهورش بيشتر از آنكه به يك نظريه انقلابي شباهت داشته باشد به نوعي توجيه براي پاره اي بديهيات تجربي شباهت داشت كه با فيزيك كلاسيك قابل بيان نبودند. سه اثر مهم اين نظريه عبارتند از: 1) از ميان برداشتن جبر گرايي كه همواره اصلي ترديد ناپذير در فيزيك كلاسيك بود، 2) گسترش مفاهيم فيزيك درباره پديده هايي كه تا پيش از آن توجيهي براي آنها وجود نداشت مانند رفتار اتم ها، مولكولها و ذرات زير اتمي و 3) با آمدن مكانيك كوانتومي اين تصور بنيادي نهفته در تفكر بشري كه واقعيتي عيني وجود دارد كه وجودش متكي بر مشاهده شدنش نيست، زير سوال رفت.

         در فيزيك، اصولا هر نظريه اي متشكل از يكسري مجردات خاص است كه آن نظريه درباره آنها بحث مي كند. هر زير مجموعه از اين مجردات كه هدف خاصي را دنبال مي كند يك سيستم در آن نظريه ناميده مي شود. در مكانيك كوانتومي، تمام ذرات بنيادي، تمام مواد شناخته شده در عالم، تمام خصوصيات فيزيكي مانند ميدانها، دماها و ... جزو مجردات مي باشند. به عبارت ديگر اين نظريه را مي توان براي هر موجود فيزيكي ( در معناي عام ) با هر اندازه و نوع به كار برد. به عنوان مثالهايي از چند سيستم كوانتومي مي توان به اتم هيدروژن با هدف تعيين موقعيت آن در يك جعبه سه بعدي، دو الكترون در يك شتابدهنده با هدف تعيين نتيجه حاصل از برخورد پر انرژي شان، يك حجم ديفرانسيلي از پرتوهاي كيهاني با هدف تعيين تكانه زاويه اي و  دو اتم در هم تافته با هدف تعيين حالت اسپيني شان اشاره كرد.


Physical Meaning of Information


         براي آنكه بدانيم در فيزيك منظورمان از اطلاعات دقيقا چيست، چند تعبير نسبتا متفاوت را از اطلاعات بايد مد نظر داشت. اين تعابير عبارتد از: 1) اطلاعات در غالب يك الگو، 2) اطلاعات در شكل ورودي حسي، 3) اطلاعات به مثابه تاثيري كه منجر به يك تغير شود و 4) اطلاعات به عنوان پيام. تعبير پيام بودن اطلاعات به آنچه در محاسبات و اطلاعات كوانتومي مطرح مي شود بسيار نزديك است. پيام بودن مستلزم آن است كه فرستنده اي به گيرنده اي مرتبط شود كه مرتبط با بحث كانال هاي ارتباطي است. البته پارازيت ها را در اين گروه قرار نمي دهيم زيرا مانع از جريان ارتباط شده و باعث بروز سوء تعبير مي شوند. اگر به اطلاعات صرفا با ديد پيام نگريسته شود، اين پيام لزوما نبايد دقيق يا درست باشد. پس اطلاعات هر نوع پيامي است كه فرستنده براي ايجاد كردن انتخاب مي كند و البته آنرا از طريق خاصي مي فرستد. اگر اطلاعات را به صورت پيام هايي كه بين فرستنده و گيرنده منتقل مي شوند فرض كنيم آنگاه مي توانيم با معياري آنها را اندازه گيري كرده و بسنجيم. اندازه گيري اطلاعات در غالب پيام، نخستين بار در 1948 توسط " كلود شانن " در نظريه اطلاعات مطرح شد. به طور خلاصه وي پيشنهاد كرد كه اگر فرستنده اي از يك مجموعه شامل N پيام با احتمال مساوي يكي را براي فرستادن انتخاب كند، در اينصورت اندازه " اطلاعاتي كه با انتخاب يك پيام از مجموعه بوجود آمده " لگاريتم در مبناي 2 عدد N است. انتخاب پايه لگاريتمي مطابق است با انتخاب يك واحد براي اندازه گيري اطلاعات. اگر از لگاريتم در پايه 2 استفاده كنيم واحدهاي حاصل را ارقام دودويي يا به اختصار بيت مي ناميم.

         با ورود فيزيك به عرصه محاسبات و اطلاعات تعابير مطرح شده توسط شانن در غالب هايي فيزيكي قرار گرفتند. مهم ترين غالب به كار رفته داخل كردن مفهوم آنتروپي براي توليد نظريه اطلاعاتي جديد بود كه در آن از مكانيك آماري كوانتومي استفاده مي شود. مفهوم اساسي آنتروپي در نظريه اطلاعات در ارتباط با اين مطلب است كه يك سيگنال يا يك رخداد اتفاقي تا چه حد تصادفي است. به عبارت ديگر مي توان پرسيد كه يك سيگنال چه ميزان از اطلاعات را حمل مي كند. براي نمونه متني را به انگليسي در نظر بگيريد كه با دنباله اي از حروف، فضاهاي خالي و علائم نگارشي كد گذاري شده است ( بنابراين، سيگنال ما در اينجا رشته اي از حروف است ). چون نمي توانيم پيش بيني كنيم كه كاراكتر بعدي دقيقا چيست، اين رشته ( يا در واقع سيگنال ) كاتوره اي است. آنتروپي در واقع معياري از اين كاتورگي است. آنتروپي يك منبع اطلاعاتي به معناي تعداد ميانگين بيت ها به ازاي علامت لازم براي كد گذاري آنها است. البته توجه به دو نكته ضروري است: اول آنكه بسياري از بيت هاي داده اي ممكن است هيچ نوع اطلاعاتي را نرسانند و دوم اينكه مقدار آنتروپي هميشه عدد صحيحي از بيت ها نيست.

         با معرفي اطلاعات فيشر به عنوان تعبير نهايي فيزيكي اطلاعات، رهيافت به حداكثر رساندن اطلاعات فيزيكي از طريق تغيير دامنه احتمال سيستم، اصل اطلاعات فيزيكي فرين (EPI) در واقع ابزاري براي كشف قوانين خالص علم است. تا آنجا كه به فيزيك مربوط مي شود، قوانين طبيعي در غالب معادلات ديفرانسيل يا توابع توزيع آشكار مي شوند، مانند تابع موج شرودينگر يا تابع توزيع فرمي- ديراك. اصل EPI بر اين تفكر استوار است كه مشاهده يك پديده " منبعي " هرگز به طور كامل دقيق نيست. يعني اطلاعات به حتم در گذر از منبع تا مشاهده شدن، گم مي شوند. مقدار بيشينه در اغلب مشاهدات كمينه است !! يعني در مشاهداتي كه انجام مي دهيم همواره تلاش مي كنيم تا به حداكثر اطلاعات توصيف كننده ساختار مورد نظر دست پيدا كنيم. مفهوم معرفي شده در اين قسمت چكيده مختصري از مفهوم اطلاعات فيزيكي است. در نظريه اطلاعات كوانتومي، بسياري از اين موارد دستخوش تغيير مي شوند.


Classical Computation


         محاسبات بدون در نظر گرفتن نوع آن، دانشي است كه براي پردازش اطلاعات بوجود آمد. به عبارت دقيق تر، از اصول محاسبات براي پردازش اطلاعات استفاده مي كنيم و از نتيجه حاصل از آن براي برقراري ارتباط با ساير مجموعه هاي فيزيكي بهره مي گيريم. علاوه بر مباني رياضي، در دانش محاسبات، مدل هايي وجود دارند كه پردازش اطلاعات با استفاده از آنها توصيف مي شود. اساسي ترين مدل، مدل ماشين تورينگ است كه قبلا به آن اشاره شد. درك كامل اين مدل به عنوان سنگ بناي دانش اطلاعات اهميت به سزايي دارد. بر اساس همين ساختار نظري، مدل مداري بوجود آمد كه منطق دودويي را به صورت فيزيكي مورد استفاده قرار داد. اين مدل، اساس دانش محاسبات و الكترونيك ديجيتال امروزي است كه در آن از جبر سوئيچينگ كه اصلاح شده جبر بول دو ارزشي است استفاده مي شود. در نظريه مداري مي توان با چند جزء اساسي و اوليه، اعمال گوناگوني را روي واحدهاي اطلاعاتي انجام داد. در واقع يك فرآيند محاسبه اي، به صورت دنباله اي از اين اعمال در نظر گرفته مي شود كه روي رشته اي از واحدهاي اطلاعاتي اجرا مي شوند. علي رغم قدرت بالايي كه سيستمهاي محاسباتي مبتني بر مدل هاي مداري تا امروز بدست آورده اند، بايد خاطر نشان كرد كه هنوز هم در اين فضا مسائلي وجود دارند كه از اين نظر غير قابل حل بوده يا به عبارت بهتر حل و محاسبه آنها با در نظر گرفتن منابع زماني و انرژي، امكان پذير نيست. از اين رو در هر مدل محاسباتي همواره بايد درك كاملي نيز از منابع محاسباتي، كلاسهاي پيچيدگي و محاسبه پذيري داشت.


Quantum Computation

         كامپيوتر تنها بخشي از دنيايي است كه ما آنرا دنياي ديجيتالي مي ناميم. پردازش ماشيني اطلاعات، در هر شكلي، بر مبناي ديجيتال و محاسبات كلاسيك انجام مي شود. اما كمتر از يك دهه است كه روش بهتر و قدرتمندتر ديگري براي پردازش اطلاعات پيش رويمان قرار گرفته كه بر اساس مكانيك كوانتومي مي باشد. اين روش جديد با ويژگيهايي همراه است كه آنرا از محاسبات كلاسيك بسيار متمايز مي سازد. گرچه محاسبات دانشي است كه اساس تولد آن در رياضيات بود، اما كامپيوترها سيستم هايي فيزيكي هستند و فيزيك در آينده اين دانش نقش تعيين كننده اي خواهد داشت. البته وجود تفاوت بين اين دو به معناي حذف يكي و جايگزيني ديگري نيست. به قول «نيلس بور» گاهي ممكن است خلاف يك حقيقت انكار ناپذير منجر به حقيقت انكار ناپذير ديگري شود. بنابراين محاسبات كوانتومي را به عنوان يك زمينه و روش جديد و بسيار كارآمد مطرح مي كنيم. وجود چند پديده مهم كه مختص فيزيك كوانتومي است، آنرا از دنياي كلاسيك جدا مي سازد. اين پديد ه ها عبارتند از: بر هم نهي(superposition) ، تداخل (interference) ، Entanglement ، عدم موجبيت (non determinism) ، نا جايگزيدگي (non locality) و تكثير ناپذيري (non clonability) . براي بررسي اثرات اين پديده ها در اين روش جديد، لازم است كه ابتدا واحد اطلاعات كوانتومي را معرفي كنيم.

         هر سيستم محاسباتي داراي يك پايه اطلاعاتي است كه نماينده كوچكترين ميزان اطلاعات قابل نمايش، چه پردازش شده و چه خام است. در محاسبات كلاسيك اين واحد ساختاري را بيت مي ناميم كه گزيده واژه «عدد دودويي» است زيرا مي تواند تنها يكي از دو رقم مجاز صفر و يك را در خود نگه دارد. به عبارت ديگر هر يك از ارقام ياد شده در محاسبات كلاسيك، كوچكترين ميزان اطلاعات قابل نمايش محسوب مي شوند. پس سيستم هايي هم كه براي اين مدل وجود دارند بايد بتوانند به نوعي اين مفهوم را عرضه كنند. در محاسبات كوانتومي هم چنين پايه اي معرفي مي شود كه آنرا كيوبيت (qubit) يا بيت كوانتومي مي ناميم. اما اين تعريف كيوبيت نيست و بايد آنرا همراه با مفهوم و نمونه هاي واقعي و فيزيكي درك كرد. در ضمن فراموش نمي كنيم كه كيوبيت ها سيستم هايي فيزيكي هستند، نه مفاهيمي انتزاعي و اگر از رياضيات هم براي توصيف آنها كمك مي گيريم تنها بدليل ماهيت كوانتومي آنها است.

         در فيزيك كلاسيك براي نگه داري يك بيت از حالت يك سيستم فيزيكي استفاده مي شود. در سيستم هاي كلاسيكي اوليه ( كامپيوترهاي مكانيكي ) از موقعيت مكاني دندانه هاي چند چرخ دنده براي نمايش اطلاعات استفاده مي شد. از زمانيكه حساب دودويي براي محاسبات پيشنهاد شد، سيستم هاي دو حالتي انتخابهاي ممكن براي محاسبات عملي شدند. به اين معني كه تنها كافي بود تا سيستمي دو حالت يا دو پيكربندي مشخص، متمايز و بدون تغيير داشته باشد تا بتوان از آن براي اين منظور استفاده كرد. به همين جهت، از بين تمام كانديداها، سيستم هاي الكتريكي و الكترونيكي براي اين كار انتخاب شدند. به اين شكل، هر بيت، يك مدار الكتريكي است كه يا در آن جريان وجود دارد يا ندارد.

         هر بيت كوانتومي يا كيوبيت عبارت است از يك سيستم دودويي كه مي تواند دو حالت مجزا داشته باشد. به عبارت فني تر، كيوبيت يك سيستم دو بعدي كوانتومي با دو پايه به شكل  و  است. البته نمايش پايه ها يكتا نيست، به اين دليل كه بر خلاف محاسبات كلاسيك در محاسبات كوانتومي از چند سيستم كوانتومي به جاي يك سيستم ارجح استفاده مي كنيم. اولين كانديد براي نمايش كيوبيت استفاده از مفهوم اسپين است كه معمولا اتم هيدروژن براي آن به كار مي رود. در اندازه گيري اسپين يك الكترون، احتمال بدست آمدن دو نتيجه وجود دارد: يا اسپين رو به بالاست كه با آنرا با  نشان مي دهيم و معادل  است و يا رو به پائين است كه با  نشان مي دهيم و معادل است با |1>| . بالا يا پائين بودن جهت اسپين در يك اندازه گيري از آنجا ناشي مي شود كه اگر اسپين اندازه گيري شده در جهت محوري باشد كه اندازه گيري را در جهت آن انجام داده ايم، آنرا بالا و اگر در خلاف جهت اين محور باشد آنرا پائين مي ناميم. علاوه بر اسپين از وضع قطبش يك پرتو فوتوني و نيز سطوح انرژي مجزاي يك اتم دلخواه نيز مي توان به عنوان سيستم كيوبيتي استفاده كرد. شايد بتوان مهم ترين تفاوت بيت و كيوبيت را در اين دانست كه بيت كلاسيك فقط مي تواند در يكي از دو حالت ممكن خود قرار داشته باشد در حاليكه بيت كوانتومي مي تواند به طور بالقوه در بيش از دو حالت وجود داشته باشد. تفاوت ديگر در اينجاست كه هرگاه بخواهيم مي توانيم مقدار يك بيت را تعيين كنيم اما اينكار را در مورد يك كيوبيت نمي توان انجام داد. به زبان كوانتومي، يك كيوبيت را با عبارت  نشان مي دهيم. حاصل اندازه گيري روي يك كيوبيت حالت |o> را با احتمال C12 و حالت |1>| را با احتمال C22 بدست مي دهد. البته اندازه گيري يك كيوبيت حتما يكي از دو نتيجه ممكن را بدست مي دهد. از سوي ديگر اندازه گيري روي سيستم هاي كوانتومي حالت اصلي آنها را تغيير مي دهد. كيوبيت در حالت كلي در يك حالت بر هم نهاده از دو پايه ممكن قرار دارد. اما در اثر اندازه گيري حتما به يكي از پايه ها برگشت مي كند. به اين ترتيب هر كيوبيت، پيش از اندازه گيري شدن مي تواند اطلاعات زيادي را در خود داشته باشد.

         بر اساس اصل برهم نهي، هر سيستم كوانتومي كه بيش از يك حالت قابل دسترس دارد، مي تواند به طور همزمان در يك تركيب خاص از آن حالت ها هم قرار داشته باشد. در اصطلاح مي گوئيم كه سيستم كوانتومي علاوه بر حالت هاي ناب يك يا چند حالت آميخته يا بر هم نهيده (blend or superposed) نيز دارد. پس اگر يك ساختار حافظه اي n كيوبيتي داشته باشيم، طبق اين اصل، اين تعداد مي توانند در پيكربندي متمايز وجود داشته باشند. به اين ترتيب يك كامپيوتر كوانتومي اين امكان را      مي يابد كه مانند يك كامپيوتر موازي كلاسيك بسيار پر قدرت عمل كند كه در يك لحظه روي چندين مسير اطلاعاتي پردازش مي كند. البته مشاهده و متمايز كردن تك تك اين محاسبه گرهاي كوانتومي غير ممكن است. چون كامپيوتر كوانتومي با تعداد بسيار زيادي مسير محاسباتي كار مي كند، مي توان كاري كرد كه اين محاسبات با هم تداخل يا بر هم تاثير هم داشته باشند. به عبارتي، محاسباتي كه به طور موازي با هم انجام مي شوند طبق اصل تداخل مي توانند اثر هم را تقويت يا تضعيف كنند. در نتيجه محاسبه اي شبكه اي بوجود مي آيد كه نوعي خاصيت جمعي از تمام محاسبات را نشان مي دهد. خاصيت بسيار شگفت انگيز در مكانيك كوانتومي خاصيت در هم تافتگي است. اگر دو يا چند كيوبيت را در بر هم كنش با هم قرار دهيم، مي توانند براي مدتي در يك حالت كوانتومي مشترك قرار بگيرند به طوريكه نتوان آن حالت را به شكل حاصلضربي از حالت هاي جدا از هم اوليه نشان داد. حالت اين واحدهاي اطلاعاتي را گنگ يا نادقيق (fuzzy) مي ناميم. يك نتيجه مهم entanglement اين است كه يك جفت كيوبيت در هم پيچيده روي يكديگر تاثير همزماني را مي گذارند كه به فاصله آنها از يكديگر و ماده اي كه اين فاصله را پر مي كند بستگي ندارد. يك جفت در هم تافته با هم مخلوط نمي شوند بلكه تنها به طور كوانتومي با هم بر هم كنش مي كنند.

Physical Implementation


         نسل اول ماشين هاي محاسبه گر اينچنيني، در واقع تماما كوانتومي نيستند. به اين معني كه تنها سعي شده است تا بخش سخت افزاري آنها بتواند در مقياس نانو و با تكيه بر مكانيك كوانتومي عمل كند. اما الگوريتم ها يا همان نرم افزارهايي كه اين كامپيوترها اجرا مي كنند، كماكان كلاسيكي هستند. از اين رو آنها را «كامپيوترهاي كلاسيكي در مقياس نانو» مي نامند. اما از آغاز قرن جديد، هدف فيزيكدانان طراحي الگوريتم هاي كوانتومي و مطابقت دادن آنها با سيستم هاي سخت افزاري پيشنهادي است تا به يك كامپيوتر كوانتومي واقعي برسند.


در سمت چپ تصوير فوق يك ترانزيستور تك الكتروني (SET) و در سمت راست عنصر محاسباتي كوانتومي يعني يك مولكول قرار دارد. مولكول فوق مربوط به كلروفرم به فرمول  است. اين مولكول ( كه در آن از اتم كربن 13 استفاده مي شود ) مانند يك آهن رباي كوچك عمل مي كند كه مي تواند با ميدانهاي مغناطيسي خارجي بر هم كنش داشته باشد. اسپين هاي هسته اي منابع ذخيره و پردازش اطلاعات هستند.

         قرن نوزدهم به قرن ماشين معروف شد. قرن بيستم نيز قرن روشهاي پردازش اطلاعات شد. اما بي شك بايد قرن بيست و يكم را صده مهندسي كوانتومي ناميد. همان طور كه ظهور مكانيك كوانتومي در يكصد سال پيش، مكانيك نيوتني را نقض نكرد بلكه آنرا تكميل تر كرد، ظهور كامپيوترهاي كوانتومي نيز به معني كنار گذاشتن محاسبات كلاسيك نيست. هدف دانشمندان تنها يافتن روشي براي بدست آوردن پرسش هاي بنيادين خود درباره طبيعت و نحوه عملكرد آن است. پس طبيعي است كه در اختيار داشتن يك ابزار محاسباتي بسيار سريع و كارآمد تا چه حد مي تواند در اين امر ياري رسان باشد. محاسبات و اطلاعات كوانتومي زمينه اي بسيار پيشرفته و نوپا در فيزيك است كه گرچه حركت آن در مقايسه با ساير زمينه ها هنوز كند است اما در مدت كمتر از 10 سال از يك به اصطلاح تئوري محض كه هيچ اميدي به محقق شدن آن نمي رفت، امروز به يك فرآورده عملي تبديل شده و به سرعت در حال پيشروي است. مراكز تحقيقاتي بزرگي در اروپا و آمريكاي شمالي از جمله انيستيتو پريميتر در كانادا، شركت IBM ، دانشگاههايي همچون آكسفورد، MIT ، هاروارد، پرينستون و چندين مركز ديگر به طور جدي روي اين موضوع مشغول تحقيق هستند. هنر فيزيك، تغيير نگرش بشر به عالم پيرامون و توصيف پديده هايي است كه مدتها برايمان جزو اسرار بودند. امروز اعتقاد داريم كه عالم در غالب يك كل، خود يك كامپيوتر كوانتومي است. اما اين ماشين چطور كار مي كند؟ برنامه ريزي و هدايت آن چطور صورت مي گيرد؟ و اينكه اصلا هدف از اين همه محاسبه چيست؟ چيستي عالم محاسباتي، همان غايت نظر فيزيكدانان است، اينكه از كجا آمده ايم و به كجا مي رويم. شايد روزي پس از عقبگرد عالم به نزديكي روزگار نخستينش، در آن انقباض دور از ذهن، در «نقطه امگا» پاسخ تمام پرسش هايمان را بيابيم.


Maysam Tehrani

منبع : http://www.nano.ir/paper.php?PaperCode=236
 

سال نو مبارک


مثل ماهي زنده
مثل سبزه زيبا
مثل سمنو شيرين
مثل سنبل خوشب
و مثل سيب خوش رنگ
و مثل سکه با ارزش باشيد
سال نو مبارک


همه چيز در مورد --> Raid <-- و مسائل مربوط به آن

همه چيز در مورد --> Raid <-- و مسائل مربوط به آن

انواع RAID مزايا و معايب هر كدام

گذرگاه IDE در طبقه بندي گذرگاههاي سيستم ، جزء گذرگاههاي خارجي محسوب مي شود و در سيستم از آن به منظور ارتباط قطعاتي مانند Rewriter ، CD-ROM ، HDD و ... استٿاده مي شود . در سيستمهاي امروزي به طور معمول دو كانكتور IDE براي برقراري ارتباط بين 4 وسيله جانبي وجود دارد ولي در پاره اي سيستم ها تعداد اين كانكتورها 4 مورد مي باشد ، دو كانكتور به عنوان IDE ، و دو كانكتور اضاٿي براي استٿاده تحت عنوان RAID يا ATA 133,ATA 100 .

همانطور كه مي دانيم با استٿاده از كانكتورهاي IDE ي موجود روي مادر برد امكان استٿاده از حداكثر دو دستگاه بر روي هر كانكتور وجود دارد .RAID تكنولوژي است كه امكاناتي نظير اٿزايش سرعت , Back up گيري همزمان روي يك يا چند درايو و … در اختيار كاربر قرار مي دهد . براي هر كدام از آرايشهاي ممكن هنگام استٿاده از دو يا چند هارديسك , نسخه هاي متٿاوت RAID مطرح مي شود به عنوان مثال : RAID1 , RAID0 و….

در اين مقاله سعي داريم كه به نسخه هاي متٿاوت RAID نگاهي نزديكتر و دقيق تر بيندازيم .

RAID0 : ذخيره سازي روي چند ديسك بدون كنترل خطا
مزايا و مشخصات :
- داده ها به بلوكهايي تبديل مي شوند و هر بلوك در هارد ديسك مجزا ذخيره مي شود.
- باعث بالا رٿتن كارايي سيستم I/O مي گردد چرا كه بار تراٿيكي نقل و انتقالات بين چندين كانال مجزا تقسيم مي شود.
- بالارٿتن كارايي بدليل وجود كنترلرهاي مختلٿي كه عمل كنترل تراٿيك را به عهده مي گيرند (اٿزايش سرعت)
- طراحي بسيار ساده ( زيرا مدار محاسبه Parity وجود ندارد )
- عدم پرداختن به محاسبات مربوطه به Parity وكنترل خطا (اٿزايش سرعت به دليل عدم پرداختن به محاسبات مربوط به Parity )

معايب :
- عدم استٿاده از Parity .(هيچ گونه كد تشخيص و تصحيح خطا در اين نوع RAID وجود ندارد ).
- از كار اٿتادن يك درايو باعث از دست رٿتن كليه اطلاعات خواهد شد.
- عدم كارايي در محيطهاي حساس به حٿظ داده ها

موارد استٿاده :
- ميكس و پردازش تصاوير ويديويي (ميكس و مونتاژ ).
- واژه پردازي (نرم اٿزارهاي تايپ و... )
- كارهايي كه نياز به سرعت بالا دارد.

Backup : RAID1 گيري همزمان داده ها به منظور Mirroring و Duplexing
Mirroning : كپي برداري هم زمان روي دو درايو
Duplexing : زماني است كه يكي از درايوها دچار مشكل شود و درايو سالمي را جايگزين نماييم سپس داده ها را روي درايو سالم كپي كنيم .
مزايا و مشخصات :
-هنگام سيكل نوشتن , گويي اطلاعات روي يك ديسك نوشته مي شود (در صورتيكه عملأ بر روي دو ديسك نوشته مي شود . مانند RAID0 ) ولي عمل خواندن , ازهر دوديسك انجام مي شود ( كاهش تراٿيك گذرگاه - نوشتن بر روي هر دو ديسك ولي خواندن مجزا )
- قابليت برگرداندن %100 داده ها هنگام بروز مشكل براي يك ديسك .
- در نرخ انتقالات داده تغيير محسوسي نداريم. (يعني وجود دو ديسك تٿاوتي با يك ديسك ندارد ) .
- در شرايط خاص RAID1, توانايي تحمل خرابي بيش از يك ديسك را نيز دارد .
- ساده ترين طراحي در تكنولوژي RAID (مدار مربوط به Parity وجود ندارد )

معايب :
- بيشترين تعداد هارد ديسك در ميان انواع RAID (بسته به انتخاب User )
- هزينه بالا

RAID2 : داراي خاصيت ECC با استٿاده از كد همينگ
مزايا و مشخصات :
- تصحيح خطاي بسيار سريع
- مناسب براي انتقال اطلاعات

معايب :
- طراحي بسيار يچيده كه با صدمه ديدن يك ديسك دچار مشكل مي شود .
- نامناسب در ديد تجاري (تعداد زياد درايوها )

كد همينگ : يكي از روشهاي محاسبه و كنترل خطا در سيستمهاي ديجيتال مي باشد . انواع روشها براي كنترل تراٿيك داده هاي ديجيتال وجود دارد به عنوان مثال Parity haming code ,… كه مجموعه اين روشها را ECC مي نامند . (Error Checking and Correcting)

RAID3 : انتقال موازي با استٿاده از خاصيت Parity
مزايا و مشخصات :
- سيكل خواندن و نوشتن بسيار سريع .

معايب :
- طراحي بسيار پيچيده كه با صدمه ديدن يك ديسك مجموعه دچار مشكل مي شود .

كاربرد :
- ميكس و مونتاژ تصوير
- ويرايش تصوير مانند RAID0

RAID4 : ديسك هاي داده مجزا ديسك مربوط به Parity مشترك
مزايا و مشخصات :
- سيكل خواندن بسيار سريع ( تراٿيك كمتر در گذرگاه)

معايب :
- پيچيدگي بسيار بالا در طراحي مدار كنترلي مشكل در برگرداندن داده ها هنگام بروز اشكال در يك ديسك ( چرا كه داده ها روي ديسكها توزيع شده است )

RAID5 : ديسك هاي داده مجزا و Parity توزيع شده در ديسكهاي Data
مزايا و مشخصات :
- در اين نوع به حداقل 3 درايو ديسك سخت نياز داريم .
- تك تك بلوك هاي داده روي ديسك ها نوشته مي شوند و Parity مربوط به هر بلوك نيز داخل هارد مربوط ذخيره مي گردد.
- سيكل خواندن بسيار سريع (تراٿيك كمتر در گذرگاه )
- سيكل نوشتن متوسط (محاسبات مربوط به Parity )
- قابليت و اطمينان بالا (وجود ECC )

معايب :
- خرابي در يك ديسك در خروجي تاثير ندارد.
- طراحي پيچيده مدار كنترلي
- مشكل در برگرداندن داده ها هنگام بروز اشكال

كاربرد :
- در سيستمهاي Server و بانكهاي اطلاعاتي ISPها

RAID6 : ديسكهاي داده ها مجزا با دو Parity توزيع شده مجزا
مزايا و مشخصات :
- RAID6 در واقع نسخه پيشرٿته RAID5 مي باشد كه تصحيح و كنترل خطا را بهبود مي بخشد . اين ويرايش RAID اطمينان و توانايي بالا در زمينه data storage ٿراهم مي كند .
- بهترين انتخاب براي كاربردهاي بحراني و حساس

معايب :
- طراحي مدار كنترلي بسيار پيشرٿته و پيچيده .
- سيكل نوشتن بسيار كند ( دوبار محاسبه مربوط به Parity )
- نياز به N+2 درايو ديسك سخت . بدليل دارا بودن حالت Parity دو بعدي . ( N تعداد ديسكهاي سخت در حالت معمولي )
- ادغام اطمينان بالا با قابليت بالا

RAID7 : نقل وانتقال بهينه شده غير همزمان به منظوردستيابي به نرخ انتقال بسيار سريع
مزايا و مشخصات :
- نقل و انتقال غير همزمان و داراي كنترلگرهاي مستقل.
- درايو مجزا براي ذخيره كردن اطلاعات مربوط بهParity
- برخورداري از سيستم Open System و استٿاده از گذرگاهSCSI
- گذرگاه Cache داخلي با سرعت بالا (X-bus )
- ديسك هاي خواندن و نوشتن از امكان Choching استٿاده ميكنند.
- تكنولوژي مدار توليد Parity تا حدودي با ساير انواع Raid تٿاوت دارد .
-امكان Hot Swaping

Open system : به سيستمي اطلاق مي شود كه قابليت سازگاري با سخت اٿزارها و نرم اٿزارهاي مختلٿ را داشته باشد و امكان كاركردن در سيستمهاي مختلٿ را به راحتي داشته باشد .

RAID10 : اين Raid حداقل به 4 دستگاه هارديسك نياز دارد
مزايا و مشخصات :
- عمل تكه تكه كردن بلوكهاي داده همانند Raid1 انجام مي پذيرد .
- تصحيح و كنترل خطا نيز مانند Raid2 مي باشد .
- نرخ انتقال بالا
- در شرايط معين , امكان تحمل خرابي چند ديسك در اين نوع RAID وجود دارد .

معايب :
- بسيار گران قيمت
- منبع تغذيه حتمأ بايد متصل به ups باشد .
- جابجايي درايوها بايد به صورت موازي انجام گيرد .
- سيستمهاي Server و بانكهاي اطلاعاتي .

RAID53 : نرخ انتقال بالا همراه با قابليت انتقال مناسب
مشخصات و مزايا :
-اين آرايه RAID حداقل به 5 دستگاه ديسك سخت نياز دارد .
- RAID53 در واقع بايد RAID03 نلميده شود زيرا عمل Striping آن همانند RAID0 بوده و Segment بندي آن نيز مانند RAID3 مي باشد.
- تحمل خطاي آن مانند RAID3 مي باشد.
- نسبت به RAID3 داراي نرخ انتقال بسيار بهتري مي باشد.

معايب :
- قيمت بالا
- همه ديسك ها بايد با همديگر سنكرون شوند كه انتخاب نوع و مدل درايو را محدود مي سازد .
- Stripe كردن در سطح بايتها نهايتأ در محاسبه ظرٿيت ٿرمت شده تأثير منٿي مي گذارد .

RAID 0+1 : نرخ انتقال داده بهينه
مزايا و مشخصات :
- حداقل به 4 دستگاه هارديسك نياز دارد .
- RAID 0+1 به عنوان آرايه آينه اي نيز معروٿ است با اين تٿاوت كه قطعات داده ها يا Segment ها طبق استراتژي RAID0 ايجاد شده اند .
- تحمل خطاي اين نوع آرايه مانند RAID5 مي باشد .
- نرخ انتقال بالا .
- بهترين انتخاب براي سيستمهايي كه به كارايي بالا بدون توجه به حداكثر اطمينان نياز داشته باشند .

معايب :
- RAID 0+1 نبايد با RAID10 اشتباه گرٿته شود . كوچكترين مشكل در عملكرد يك درايو , آرايه را به مدل RAID0 تبديل خواهد كرد .
- قيمت بسيار بالا
- جابجايي درايوها بايد به صورت موازي انجام گيرد .

كاربرد :
- پردازشهاي تصويري و fileserever هاي عمومي .

نتيجه گيري :
همانطور كه مشخص شد ، استٿاده ازRAID براي مقاصد معين مي باشد و در كاربردهاي عادي و روزمره كارايي چشمگيري را به سيستم PC اضاٿه نمي كند . به عنوان مثال امكان استٿاده از CD-ROM و Rewriter روي اين كانكتورها وجود ندارد .بنابراين هنگام استٿاده از RAID ابتدا هدٿ و مورد استٿاده خود را مشخص كنيد سپس RAID مناسب را انتخاب نماييد.

منبع: مجله رايان


مقالات ديگه ...

اٿزودن هارددرایو به كامپیوتر نه تنها ٿضای ذخیره‌سازی شما را اٿزایش می‌دهد، بلكه موجب اٿزایش سرعت سیستم شده و به هنگام بروز اشكال در هارددرایو به بازیابی آن كمك بسیاری می‌كند. درایوهایی كه به صورت RAID پیكربندی می‌شوند، نتیجه بهتری نسبت به بقیه درایوها ارائه می‌دهند. در هر نوع RAID آمادگی در برابر خطای سیستم به گونه‌ای متٿاوت است.

◿ RAID۰:
این مرحله داده‌ها را مابین دو یا چند درایو توزیع می‌كند كه این امر سرعت انتقال داده‌ها را اٿزایش می‌دهد. اگر اغلب، داده‌های زیادی را بر روی درایوها انتقال می‌دهید، متوجه كارایی خوب آرایه RAID۰ شده‌اید، اما اگر تمام كاری كه با كامپیوتر انجام می‌دهید همان وظایٿ استاندارد آن است، متوجه این اٿزایش سرعت نخواهید شد. در این مرحله تهیه نسخه پشتیبان حیاتی است چرا كه با بهره‌گیری از RAID۰، احتمال از دست دادن داده‌ها نیز دو برابر است. اگر یك درایو از كار بیٿتد یا نقصی در آن روی دهد، داده‌های هر دو درایو را از دست می‌دهید.

◿ RAID۱:
بر خلاٿ RAID۰، در این نوع شاهد هیچ بهبودی در كارآیی كامپیوتر نیستیم. بلكه در این نوع با ایجاد یك كپی دقیق یا قرینه از اطلاعات هارد درایو اول روی هارد درایو دوم به طور بلادرنگ، میزان خرابی به حداقل ممكن رسیده است. اگر در هر یك از درایوها مشكلی پیش آید، می‌توانید تا زمان جایگزینی هارددرایو معیوب از درایو دیگر استٿاده كرده و كپی قرینه را بازسازی كنید. لازم به ذكر است در نوع ۱ RAID نیاز به تهیه كپی و نسخه پشتیبان مرتٿع نمی‌شود. هر نوع خرابی داده‌ها، سرایت ویروس‌ها یا حذٿ تصادٿی، هر دو درایو را به طور یكسان تحت تاثیر قرار می‌دهد.

◿ RAID ۱+s:
برای نصب هارددرایو سومی كه تا زمان خرابی درایو راه‌انداز غیرٿعال باشد، كنترل كننده‌های RAID خاصی از این ٿناوری پشتیبانی می‌كنند. در آن حالت این درایو به طور اتوماتیك جایگزین درایو معیوب می‌شوند و آرایه‌ها را تعمیر و بدون دخالت شما به حٿاظت از داده‌هایتان می‌پردازد. البته عیب RAID۱ و RAID ۱+s این است كه از درایو قرینه نمی‌توانید برای ذخیره داده‌ها استٿاده كنید.

◿ ۰+۱ RAID و ۰+۱ RAID :
ه۱+۰ RAID درایوهایی را كه به چند بخش تقسیم شده‌اند، را قریبه‌سازی می‌كند (بدین ترتیب كه نسخه پشتیبان قرینه‌ای از داده‌هایی كه به منظور بهبود قابلیت اطمینان در درایوهای مختلٿی قرار گرٿته‌اند، ایجاد می‌كند) و ۰+۱ RAID درایوهای قرینه را به بخش‌هایی تقسیم می‌كند (بدین ترتیب كه نسخه‌های پشتیبان درایوهای متعدد انتقال می‌دهد تا عملكرد دستگاه بهبود یابد.) هر دو پیكربندی حداقل نیازمند ۴ هارددرایوهستند.

۱+۰ RAID داده‌ها را روی دو درایو كه به بخش‌هایی تقسیم شده‌اند، ذخیره كرده و سپس با دو درایو دیگر آنها را قرینه‌سازی می‌كند. ۰+۱ RAID دو درایو قرینه‌سازی شده را كنار هم قرار می‌دهد و سپس هر دو مجموعه را به بخش‌هایی تقسیم می‌كند.

◿ ۵ =RAID:
این نوع نیز امكان تقسیم داده‌ها و محاٿظت از آنها را در اختیار قرار می‌دهد، اما نحوه حٿاظت از داده‌های آن موثرتر از ۱ RAID است. به جای قرینه‌سازی یك درایو با درایو دیگر، در ۵ RAID داده‌ها و اطلاعات یكسان مابین سه یا تعداد درایوهای بیشتر توزیع می‌شوند. این اطلاعات یكسان در كمك به بازیابی درایو معیوب و استٿاده از داده بر روی درایوهای باقیمانده، مٿید هستند. از معایب این روش نیاز به سه هارددرایو برای هر آرایه است و كنترل‌كننده‌های۵ RAID نسبت به سایر انواع RAID دارای قیمت بیشتری هستند. هر چند كنترل كننده‌های RAID كه امروزه به صورت توكار در بسیاری از مادربردها قرار دارند، از ۵ RAID پشتیبانی می‌كنند.

◿ برنامه‌ریزی برای RAID
نصب و برپایی RAID نیازمند دو یا چند هارددرایو است و در این راستا برای هر درایو به یك SATA یا IDE باز نیاز است كه اغلب مادربردهای جدید با آن یكپارچه شده‌اند. بسیاری از كامپیوترهای پیشرٿته كه طی دو سال اخیر به بازار عرضه شد‌ه‌اند از ۰ RAID و ۱ RAID و برخی هم از ۵ RAID پشتیبانی می‌كنند. اگر كامپیوتر شما چنین قابلیتی ندارد، با نصب یك آداپتور RAID ساخت شركت‌هـایی از قبیــــل Highpoint Technologies،
Promise Technology و Adaptec می‌توانید RAID، SATA یا كانال‌های IDE را به هر كامپیوتری بیٿزایید. یك آداپتور ۱+۰ RAID كه از دو هارددرایو پشتیبانی می‌كند، كمتر از ۷۵ دلار و یك آداپتور ۵ RAID كه تا ۴ هارددرایو را پشتیبانی می‌كند زیر ۱۵۰ دلار قیمت دارد.

در ادامه به ارائه نكات سودمندی درباره RAID می‌پردازیم.
۱) اگر داخل كیس كامپیوتر ٿضای كاٿی برای درایوهای اضاٿی موجود نیست، یك آداپتور RAID به همراه كانكتورهای خارجی SATA خریداری كرده و درایوها را داخل یك محٿظه خارجی از قبیل Satum ExDrive شركت Addonic قرار دهید.

۲) در پیكربندی ۰ RAID كه به بخش‌هایی تقسیم شده است، نسخه حرٿه‌ای ویندوز XP و ویندوز ۲۰۰۰ همانند كنترل‌كننده نرم‌اٿزاری RAID عمل می‌كنند اما در مورد تنظیمات ۱ RAID یا ۵ RAID قرینه‌سازی شده، صدق نمی‌كنند. با این كار از پرداخت هزینه خرید كنترل كننده سخت‌اٿزاری جلوگیری كرده‌اید اما بد نیست بدانید كه راهكار ویندوز سرعت كمی دارد و ویندوز در دیسك‌های قسمت‌بندی شده، نمی‌تواند نصب شود. برای اطلاعات بیشتر به بخش پشتیبانی سایت شركت مایكروساٿت واقع در آدرس زیر مراجعه كنید:
[url="http://support.microsoft./com/kb/۳۰۸۴۲۴/en_us"]http://support.microsoft./com/kb/۳۰۸۴۲۴/en_us[/URL
]

) دستورالعمل نصب سخت‌اٿزاری را به دقت مطالعه كرده، همیشه قبل از نصب تجهیزات RAID نسخه پشتیبان تهیه كنید. اگر مشكلی حین نصب پیش آید منجر به خرابی داده‌های درایو می‌شود. قبل از آغاز بهتر است كه اطلاعات مربوط به نصب و به روزرسانی درایو را از طریق وب سایت شركت سازنده آن مطالعه كنید.

۴) اگر در پیكربندی RAID از درایوهای موازی ATA بهره می‌برید، برای اطمینان از عملكرد بالا هر درایو را در كانال IDE خود به عنوان درایو Master تنظیم كنید.

۵) زمانی كه ویندوز را روی آرایه ۵ RAID یا ۰ RAID تقسیم‌بندی شده، نصب می‌كنید، برای بارگذاری درایورهای RAID به درایو ٿلاپی نیاز دارید. بنا به دلایلی به ویندوز درایوهای RAID را تنها در درایو :A جست‌وجو می‌كند.

منبع:آٿتاب و p30world


◿ RAID چیست؟
کوتاه شده عبارت Redundant Array of Inexpensive Disks میباشد و کار آن ایجاد یک واحد از مجموع چند هارد دیسک میباشد. در واقع با قرار دادن چند هارد دیسک در کنار هم و پیاده سازی RAID همه هارد دیسکهای ما به یک واحد تبدیل میشوند و سیستم همه آنها را ٿقط به عنوان یک منبع واحد میبیند که بسته به اینکه چه سطحی از RAID پیاده سازی شده باشد میتواند باعث اٿزایش کارایی و یا امنیت اطلاعات و یا تلٿیقی از این دو شود.
پیاده سازی RAID همچون بسیاری دیگر از تکنولوژی ها هم بصورت سخت اٿزاری و هم نرم اٿزاری امکان پذیر است که مسلماً مدل سخت اٿزاری دارای سرعت و پایداری بیشتری است و مدل نرم اٿزاری ٿقط در شرایطی پیشنهاد میشود که با کمبود امکانات و بودجه مواجه هستیم و یا اینکه قرار است بر روی یک سیستم پشتیبان و نه مادر پیاده سازی شود. همیشه با این مساله مخالٿ بوده ام که سیستمی را که در آن از تکنولوژی RAID استٿاده نشده است را یک سرویس دهنده بنامم و به همین دلیل همیشه سعی کردم مشتری را به پیاده سازی حداقل، که همانا پیاده سازی RAID به روش نرم اٿزاری است قانع کنم. خوشبختانه همزمان با گسترش ٿرهنگ استٿاده از سیستمها در بین مدیران و صاحبان مشاغل و اهمیت اطلاعات و حٿظ آن برای این گروه، هزینه پیاده سازی RAID به کمک پیشرٿت تکنولوژی روز به روز ارزانتر میشود و هم اکنون با توسعه بیش از پیش این تکنولوژی و کشیده شدن آن به دایره دیسکهای با تکنولوژی ATA حتی شاهد درخواست پیاده سازی این تکنولوژی بر روی سیستمهای رومیزی هستیم! اما ٿارغ از اینکه RAID بصورت نرم اٿزاری و یا سخت اٿزاری پیاده سازی میشود و یا نیاز ما استٿاده از هارد دیسکهای SCSI و یا ATA است، تکنولوژی RAID دارای سطوح گوناگون است که در ادامه به ذکر عمده ترین آنها میپردازم:
◿ RAID۰
ذخیره سازی روی چند دیسک بدون کنترل خطا مزایا و مشخصات : - داده ها به بلوکهایی تبدیل می شوند و هر بلوک در هارد دیسک مجزا ذخیره می شود. - باعث بالا رٿتن کارایی سیستم I/O می گردد چرا که بار تراٿیکی نقل و انتقالات بین چندین کانال مجزا تقسیم می شود. - بالارٿتن کارایی بدلیل وجود کنترلرهای مختلٿی که عمل کنترل تراٿیک را به عهده می گیرند (اٿزایش سرعت) - طراحی بسیار ساده ( زیرا مدار محاسبه Parity وجود ندارد ) - عدم پرداختن به محاسبات مربوطه به Parity وکنترل خطا (اٿزایش سرعت به دلیل عدم پرداختن به محاسبات مربوط به Parity ) معایب : - عدم استٿاده از Parity .(هیچ گونه کد تشخیص و تصحیح خطا در این نوع RAID وجود ندارد ). - از کار اٿتادن یک درایو باعث از دست رٿتن کلیه اطلاعات خواهد شد. - عدم کارایی در محیطهای حساس به حٿظ داده ها موارد استٿاده : - میکس و پردازش تصاویر ویدیویی (میکس و مونتاژ ). - واژه پردازی (نرم اٿزارهای تایپ و... ) - کارهایی که نیاز به سرعت بالا دارد.
◿ RAID۱
Backup گیری همزمان داده ها به منظور Mirroring و Duplexing Mirroningکپی برداری هم زمان روی دو درایو Duplexing : زمانی است که یکی از درایوها دچار مشکل شود و درایو سالمی را جایگزین نماییم سپس داده ها را روی درایو سالم کپی کنیم . مزایا و مشخصات : -هنگام سیکل نوشتن , گویی اطلاعات روی یک دیسک نوشته می شود (در صورتیکه عملأ بر روی دو دیسک نوشته می شود . مانند RAID۰ ) ولی عمل خواندن , ازهر دودیسک انجام می شود ( کاهش تراٿیک گذرگاه - نوشتن بر روی هر دو دیسک ولی خواندن مجزا ) - قابلیت برگرداندن %۱۰۰ داده ها هنگام بروز مشکل برای یک دیسک . - در نرخ انتقالات داده تغییر محسوسی نداریم. (یعنی وجود دو دیسک تٿاوتی با یک دیسک ندارد ) . - در شرایط خاص RAID۱, توانایی تحمل خرابی بیش از یک دیسک را نیز دارد . - ساده ترین طراحی در تکنولوژی RAID (مدار مربوط به Parity وجود ندارد ) معایب : - بیشترین تعداد هارد دیسک در میان انواع RAID (بسته به انتخاب User ) - هزینه بالا
◿ RAID۲
دارای خاصیت ECC با استٿاده از کد همینگمزایا و مشخصات : - تصحیح خطای بسیار سریع - مناسب برای انتقال اطلاعات معایب : - طراحی بسیار یچیده که با صدمه دیدن یک دیسک دچار مشکل می شود . - نامناسب در دید تجاری (تعداد زیاد درایوها ) کد همینگ : یکی از روشهای محاسبه و کنترل خطا در سیستمهای دیجیتال می باشد .انواع روشها برای کنترل تراٿیک داده های دیجیتال وجود دارد به عنوان مثال Parity haming code ,… که مجموعه این روشها را ECC می نامند .
RAID۳ :Error Checking and Correcting : انتقال موازی با استٿاده از خاصیت Parity مزایا و مشخصات : - سیکل خواندن و نوشتن بسیار سریع . معایب : - طراحی بسیار پیچیده که با صدمه دیدن یک دیسک مجموعه دچار مشکل می شود . کاربرد : - میکس و مونتاژ تصویر - ویرایش تصویر مانند RAID۰
◿ RAID۴
دیسک های داده مجزا دیسک مربوط به Parity مشترک مزایا و مشخصات : - سیکل خواندن بسیار سریع ( تراٿیک کمتر در گذرگاه) معایب : - پیچیدگی بسیار بالا در طراحی مدار کنترلی مشکل در برگرداندن داده ها هنگام بروز اشکال در یک دیسک ( چرا که داده ها روی دیسکها توزیع شده است )
◿ RAID۵
دیسک های داده مجزا و Parity توزیع شده در دیسکهای Data مزایا و مشخصات : - در این نوع به حداقل ۳ درایو دیسک سخت نیاز داریم . - تک تک بلوک های داده روی دیسک ها نوشته می شوند و Parity مربوط به هر بلوک نیز داخل هارد مربوط ذخیره می گردد. - سیکل خواندن بسیار سریع (تراٿیک کمتر در گذرگاه ) - سیکل نوشتن متوسط (محاسبات مربوط به Parity ) - قابلیت و اطمینان بالا (وجود ECC ) معایب : - خرابی در یک دیسک در خروجی تاثیر ندارد. - طراحی پیچیده مدار کنترلی - مشکل در برگرداندن داده ها هنگام بروز اشکال کاربرد : - در سیستمهای Server و بانکهای اطلاعاتی ISPها
◿ RAID۶
دیسکهای داده ها مجزا با دو Parity توزیع شده مجزا مزایا و مشخصات : - RAID۶ در واقع نسخه پیشرٿته RAID۵ می باشد که تصحیح و کنترل خطا را بهبود می بخشد . این ویرایش RAID اطمینان و توانایی بالا در زمینه data storage ٿراهم می کند . - بهترین انتخاب برای کاربردهای بحرانی و حساس معایب : - طراحی مدار کنترلی بسیار پیشرٿته و پیچیده . - سیکل نوشتن بسیار کند ( دوبار محاسبه مربوط به Parity ) - نیاز به N+۲ درایو دیسک سخت . بدلیل دارا بودن حالت Parity دو بعدی . ( N تعداد دیسکهای سخت در حالت معمولی ) - ادغام اطمینان بالا با قابلیت بالا
◿ RAID۷
نقل وانتقال بهینه شده غیر همزمان به منظوردستیابی به نرخ انتقال بسیار سریع مزایا و مشخصات : - نقل و انتقال غیر همزمان و دارای کنترلگرهای مستقل. - درایو مجزا برای ذخیره کردن اطلاعات مربوط بهParity - برخورداری از سیستم Open System و استٿاده از گذرگاهSCSI - گذرگاه Cache داخلی با سرعت بالا (X-bus ) - دیسک های خواندن و نوشتن از امکان Choching استٿاده میکنند. - تکنولوژی مدار تولید Parity تا حدودی با سایر انواع Raid تٿاوت دارد . -امکان Hot Swaping Open system : به سیستمی اطلاق می شود که قابلیت سازگاری با سخت اٿزارها و نرم اٿزارهای مختلٿ را داشته باشد و امکان کارکردن در سیستمهای مختلٿ را به راحتی داشته باشد .
◿ RAID۱۰
این Raid حداقل به ۴ دستگاه هاردیسک نیاز دارد مزایا و مشخصات : - عمل تکه تکه کردن بلوکهای داده همانند Raid۱ انجام می پذیرد . - تصحیح و کنترل خطا نیز مانند Raid۲ می باشد . - نرخ انتقال بالا - در شرایط معین , امکان تحمل خرابی چند دیسک در این نوع RAID وجود دارد . معایب : - بسیار گران قیمت - منبع تغذیه حتمأ باید متصل به ups باشد . - جابجایی درایوها باید به صورت موازی انجام گیرد . - سیستمهای Server و بانکهای اطلاعاتی .
◿ RAID۵۳
نرخ انتقال بالا همراه با قابلیت انتقال مناسب مشخصات و مزایا : - این آرایه RAID حداقل به ۵ دستگاه دیسک سخت نیاز دارد . - RAID۵۳ در واقع باید RAID۰۳ نامیده شود زیرا عمل Striping آن همانند RAID۰ بوده و Segment بندی آن نیز مانند RAID۳ می باشد. - تحمل خطای آن مانند RAID۳ می باشد. - نسبت به RAID۳ دارای نرخ انتقال بسیار بهتری می باشد. معایب : - قیمت بالا - همه دیسک ها باید با همدیگر سنکرون شوند که انتخاب نوع و مدل درایو را محدود می سازد . - Stripe کردن در سطح بایتها نهایتأ در محاسبه ظرٿیت ٿرمت شده تأثیر منٿی می گذارد .
◿ RAID ۰+۱
▪ نرخ انتقال داده بهینه مزایا و مشخصات : - حداقل به ۴ دستگاه هاردیسک نیاز دارد . - RAID ۰+۱ به عنوان آرایه آینه ای نیز معروٿ است با این تٿاوت که قطعات داده ها یا Segment ها طبق استراتژی RAID۰ ایجاد شده اند . - تحمل خطای این نوع آرایه مانند RAID۵ می باشد . - نرخ انتقال بالا . - بهترین انتخاب برای سیستمهایی که به کارایی بالا بدون توجه به حداکثر اطمینان نیاز داشته باشند . معایب : - RAID ۰+۱ نباید با RAID۱۰ اشتباه گرٿته شود . کوچکترین مشکل در عملکرد یک درایو , آرایه را به مدل RAID۰ تبدیل خواهد کرد . - قیمت بسیار بالا - جابجایی درایوها باید به صورت موازی انجام گیرد . کاربرد : - پردازشهای تصویری و fileserever های عمومی .
▪ نتیجه گیری : همانطور که مشخص شد ، استٿاده ازRAID برای مقاصد معین می باشد و در کاربردهای عادی و روزمره کارایی چشمگیری را به سیستم PC اضاٿه نمی کند . به عنوان مثال امکان استٿاده از CD-ROM و Rewriter روی این کانکتورها وجود ندارد . بنابراین هنگام استٿاده از RAID ابتدا هدٿ و مورد استٿاده خود را مشخص کنید سپس RAID مناسب را انتخاب نمایید.

منبع: شبکه رشد


كلاسترينگ (3)

 كلاسترينگ (3)

در اين مقاله ساير الگوريتمهاي كلاسترينگ توضيح داده شده اند

K-means clustering:


K- Means ،يکي از ساده ترين الگوريتم هاي يادگيري بدون نظارت است که مسائل کلاسترينگ معروف را حل مي کند. اين الگوريتم از يک شيوه ساده براي کلاسيفاي کردن يک مجموعه داده در يک تعداد از پيش مشخص شده (k) کلاستر،استفاده مي کند.ايده اصلي تعريف k مرکز براي هر يک از کلاستر ها مي باشد . اين مراکز بايستي با دقت زياد انتخاب شوند ، زيرا مراکز مختلف ، نتايج مختلف را به وجود مي آورند.
بنابراين بهترين انتخاب قرار دان آنها (مراکز) در فاصله هر چه بيشتر از يکديگر مي باشد . قدم بعدي تخصيص هر الگو به نزديک ترين مرکز مي باشد. وقتي همه ي نقاط به مراکز موجود تخصيص داده شدند، مرحله اول تکميل شده است و يک گروه بندي اوليه انجام شده است. در اين مرحه نياز داريم که k مرکز جديد براي کلاستر هاي مرحله قبل محاسبه کنيم. بعد از تعيين k مرکز جديد ،مجدداً داده ها را به مراکز مناسب تخصيص مي دهيم.
اين مراحل را آنقدر تکرار مي کنيم که ديگر k مرکز ،جابجا نشوند.
اين الگوريتم تلاش مي کند که يک تابع هدف (Objective Function) را که تابع  Squared error مي باشد ، مينيمم کند: 
 

اين الگوريتم از مراحل زير تشکيل شده است:
1- مشخص کردن مراکز اين نقاط معرفي کنند مراکز گروه هاي اوليه مي باشند.
2- تخصيص هر الگو به گروهي که نزديکترين مرکز به الگوي مربوطه را دارد.
3- وقتي که تمام الگو ها تخصيص داده شدند،موقعيت k مرکز دوباره محاسبه مي شود.
4- مراحل 2 و 3 آنقدر تکرار مي شوند تا مراکز ديگر جابجا نشوند.
اگر چه ثابت شده است که الگوريتم هميشه پايان ميپذيرد،الگوريتم k-mean ،لزوما جواب بهينه را پيدا نمي کند. اين الگوريتم داراي حساسيت زيادي به مراکز کلاستر اوليه است که به صورت تصادفي انتخاب مي شوند.براي کاهش اين تاثير مي توان الگوريتم را چندين بار اجرا کرد.
k-means ، يک الگوريتم ساده است که براي بسياري از کاربردها مناسب مي باشد.

Fuzzy C-means Clustering:


FCM ،يک روش کلاسترينگ است که اجازه مي دهد يک الگو به دو يا چند کلاستر تعلق داشته باشد.اين روش اغلب در باز شناسي الگو مورد استفاده قرارمي گيرد .

 منبع : http://www.30sharp.com


الگوریتم کلاسترینگ (2)

 الگوریتم کلاسترینگ (2)

در این مقاله به توضیح الگوریتم کلاسترینگ سلسله مراتبی پرداخته ایم.

کلاسترينگ سلسله مراتبي (Hierarchical Clustering)


با در دست داشتن N نمونه داده براي کلاستر شدن و يک ماتريس فاصله يا شباهت به ابعاد N*N ، پروسه اصلي کلاستريگ سلسله مراتبي به صورت زير ميباشد :

1. با تخصيص هر نمونه به يک کلاستر شروع کنيد . يعني اگر N نمونه داشته باشيم ، N کلاستر داريم که هر يک داراي يک نمونه مي باشند . فاصله بين کلاستر ها همان فاصله بين کلاستر هاي آنهاست .

2. دو کلاستري را که نزديک تر هستند پيدا کنيد و آنها را ادغام کنيد . حالا يک کلاستر کمتر داريم .

3. فاصله کلاستر جديد را با هر يک از کلاسترهاي قديمي محاسبه کنيد .

4. مراحل 2 و3 را آنقدر تکرار کنيد که همه نمونه ها در يک کلاستر به اندازه N قرار بگيرند

مرحله 3 مي تواند به روش هاي مختلفي انجام گيرد که کلاستريگ single-linkage ، complete-linkage و Average-linkage را مشخص مي کند .
در کلاستريگ single-linkage (که روش connectedness يا minimum هم ناميده مي شود( ، فاصله يک کلاستر از کلاستر ديگر را کوتاهترين فاصله هر عضو از کلاستر اول تا هر عضو از کلاستر دوم در نظر مي گيرند .
اگر داده ها شامل شباهت باشند ، شباهت يک کلاستر تا کلاستر ديگر را برابر بيشترين شباهت هر عضو از کلاستر اول تا هر عضو از کلاستر دوم در نظر مي گيرند .
در کلاستريگ complete-linkage (که روش diameter يا maximum هم ناميده مي شود(، فاصله يک کلاستر از کلاستر ديگر را بزرگترين فاصله هر عضو از کلاستر اول تا هر عضو از کلاستر دوم در نظر مي گيرند .
در کلاستريگ average-linkage ، فاصله يک کلاستر از کلاستر ديگر را ميانگين فاصله هر عضو از کلاستر اول تا هر عضو از کلاستر دوم در نظر مي گيرند .

کلاستريگ سلسله مراتبي ، agglomerative يا متراکم شونده نيز ناميده مي شود ، زيرا کلاستر ها را به تدريج ادغام مي کند .کلاسترينگ تقسيم کننده يا divisive هم وجود دارد که به صورت عکس عمل مي کند ، به اين صورت که ابتدا همه اشياء را در يک کلاستر قرار مي دهد و به تدريج آن را به قطعه هاي کوچکتر تقسيم مي کند.
البته اين نوع کلاستريگ به ندرت مورد استفاده قرار مي گيرد .

الگوريم کلاسترينگ single-linkage :


اين الگوريم agglomerative است و زمانيکه کلاستر ها براي تشکيل کلاستر هاي جديد ، ادغام مي شوند ، سطرها و ستون هاي مربوط به آنها را در ماتريس مجاورت پاک مي کند .

ماتريس مجاورت به ابعاد N*N ، D = [d(i,j)] را در نظر بگيريد . به کلاستر ها اعداد 0 و 1 و ... و n-1 ، تخصطص داده مي شود و  L(k) ، سطح k امين کلاسترينگ است . کلاستري با شماره m به صورت (m) نمايش داده مي شود و مجاورت بين کلاسترهاي (r) و (s) به صورت d[(r) , (s)] نمايش داده مي شود .

الگوريتم شامل مراحل زير است :

1. با کلاسترينگ با سطح L(0)=0 و m=0 شروع کنيد .
2. بي شباهت ترين جفت از کلاستر ها را پيدا کنيد . ((r),(s)) :
D[(r),(s)] = min d[(i),(j)]
مينيمم بين همه جفت کلاسترها در نظر گرفته مي شود .
3.m=m+1   قرار دهيد . کلاستر هاي (r) و (s) را ادغام کنيد تا تا کلاستريگ بعدي را تشکيل دهد . سطح کلاستريگ را به اين صورت تنظيم کنيد :
L(m) = d[(r),(s)]
4.  ماتريس مجاورت (D) را update کنيد . به اين ترتيب که سطرها و ستون هاي مربوط به کلاسترهاي(r) و (s) را حذف کنيد و يک سطر و ستون جديد براي کلاستري که تازه تشکيل شده ايجاد کنيد .
مجاورت بين کلاستر جديد (r,s) و کلاستر هاي قديمي k به اين ترتيب محاسبه مي شود:
d [(k), (r,s)] = min d[(k),(r)], d[(k),(s)]
5. اگر تمام اشياء در يک کلاستر قرار گرفتند متوقف مي شويم ، در غير اين صورت به مرحله 2 باز مي گرديم . 

يک مثال :
به عنوان مثال يک کلاسترينگ از فواصل بين يک سري از شهر هاي ايتاليايي که بر حسب کيلومتر بيان شده اند را بررسي مي کنيم . روش استفاده شده  ، single-linkage مي باشد .
ماتريس فاصله که ورودي مي باشد به صورت زير است : (براي همه کلاستر ها L=0 مي باشد .)

نزديکترين شهرها MI و TO هستند ، که به فاصله 138 کيلومتر مي باشند . آنها در يک کلاستر به نام MI/TO ادغام مي شوند . سطح کلاستر جديد L(MI/TO) = 138 و m=1 مي باشد .
مي توانيم فاصله اين شيء ترکيبي را از همه اشياء ديگر محاسبه کنيم . در کلاسترينگ single-linkage ، قانون اين است که فاصله شيء ترکيبي تا ساير اشياء ، برابر کوتاهترين فاصله از هر عضو از کلاستر تا شيء خارجي مي باشد . بنابراين فاصله MI/TO تا RM ، 564 انتخاب مي شود که فاصله از MI تا RM مي باشد.بعد از ادغام MI و TO ، خواهيم داشت :


min d(i,j) = d(NA,RM) = 219 =>    
NA وRM در کلاستر جديدي به نام NA/RM ادغام مي شوند .

L(NA/RM) = 219
m = 2


min d(i,j) = d(BA,NA/RM) = 255 =>
BA و NA/RM در کلاستر جديدي به نام BA/ NA/RM  ادغام مي شوند .
L(BA/NA/RM) = 255
m = 3


min d(i,j) = d(BA/NA/RM,FI) = 268 =>
BA/NA/RM و FI در کلاستر جديدي به نام BA/FI/NA/RM  ادغام مي شوند .
L(BA/FI/NA/RM) = 268
m = 4
 

نهايتاً دو کلاستر باقيمانده را در سطح 295 ادغام مي کنيم .
پروسه انجام شده به صورت خلاصه در ساختار سلسله مراتبي درخت زير نمايش داده شده است .

مشکلات :

نقاط ضعف اصلي روش هاي کلاسترينگ agglomerative عبارتند از :
? پيچيدگي زماني ، حداقل ( O(n است که n ، تعداد کل اشياء مي باشد .
? مراحلي که قبلاً انجام شده ، قابل بازگشت نيستند و نمي توان تأثير قدم هاي قبلي را undo کرد .

 منبع : http://www.30sharp.com


الگوریتم های کلاسترینگ (1)

 الگوریتم های کلاسترینگ (1)

در این مقاله به توضیح یکی از الگوریتمهای کلاسترینگ (مدل ترتیبی) پرداخته ایم.

در اين قسمت انواع الگوريتم هاي کلاسترينگ را بررسي مي کنيم. الگوريتم هاي کلاسترينگ را مي توان به دسته هاي اصلي زير تقسيم بندي کرد:


• الگوريتم هاي کلاسترينگ ترتيبي
• الگوريتم هاي کلاسترينگ سلسله مراتبي
• الگوريتم هاي کلا سترينگ مبتني بر بهينه سازي تابع هزينه


الگوريتم هاي کلاسترينگ ترتيبي


اين الگوريتم ها در ابتدا يک کلاستر تک توليد مي کنند و روش هاي سريع و واضحي مي باشند. در اکثر آنها بردارهاي خصوصيات به تعداد دفعات کمي و يا تنها يک بار به الگوريتم داده مي شوند. در اينجا بطور خلاصه الگوريتم ترتيبي پايه را توضيح مي دهيم. در اين نمونه تمام بردارها يک بار به الگوريتم ارائه مي شوند. تعداد دسته ها در اين مورد از قبل مشخص نيستند. در واقع کلاسترهاي جديد در حين اجراي برنامه ايجاد مي شوند. اگر   به معناي فاصله (عدم شباهت) بين بردار خصوصيت و کلاستر  باشد، هر بردار  بسته به فاصله از کلاستر، به کلاسترهاي موجود و يا به کلاستر جديد نسبت داده مي شود. در زير الگوريتم کلاسترينگ ترتيبي پايه آورده شده است.


در الگوريتم هاي کلاسترينگ ترتيبي نتيجه نهايي به ترتيبي که بردارها به الگوريتم ارائه مي شوند بستگي دارد.

درمقالات بعدي ساير الگوريتمهاي کلاسترينگ را توضيح خواهيم داد.

منبع : http://www.30sharp.com


مفاهیم اولیه کلاسترینگ

 مفاهیم اولیه کلاسترینگ

در این  مقاله توضیح مختصری از مفاهیم پایه کلاسترینگ ارائه شده است.

معرفي


کلاسترينگ به معناي کلاس بندي بدون نظارت است که کلاسها از قبل تعيين شده نيستند و يا به عبارت ديگر برچسب کلاس الگوهاي آموزشي در دسترس نيست. بنابراين اکنون هدف اصلي ما سازماندهي الگوها به گروهاي sensible است. که به ما اجازه مي دهند که شباهت و تفاوت بين الگوها را کشف کنيم و نتايج مفيد را درباره آنها استنتاج نماييم. اين ايده در زمينه هاي مختلف ديده مي شود. مثال زير از زيست شناسي الهام گرفته شده است و صورت مسئله را براي ما واضح مي سازد. به حيوانات زير توجه کنيد: گوسفند،سگ و گربه (پستاندار)، گنجشک و بلبل (پرنده)، ماهي قرمز، شاه ماهي (ماهي)، افعي و  مارمولک(خزنده) و غوک(دوزيست). به منظور مرتب کردن اين حيوانات در داخل کلاسترها نياز داريم که يک ملاک دسته بندي تعريف کنيم. اگر وجود شش ها را بررسي کنيم، ماهي قرمز و شاه ماهي در يک کلاستر و بقيه در يک کلاستر ديگر قرار مي گيرند(شکل(الف)). اگر ملاک دسته بندي را محيطي که حيوانات زندگي مي کنند قرار دهيم آنگاه گوسفند، سگ، گربه، گنجشک، بلبل،افعي و مارمولک (حيواناتي که بيرون آب زندگي مي کنند) کلاستر اول و ماهي قرمز و شاه ماهي (حيواناتي که در آب زندگي مي کنند) کلاستر دوم را تشکيل مي دهند و غوک که مي تواند هم در آب و هم در خشکي زندگي کند کلاستر سوم را تشکيل مي دهد (شکل (ب)). اگر وجود ستون فقرات را ملاک دسته بندي باشد تمام حيوانات در يک دسته قرار مي گيرند. ما مي توانيم از ملاک دسته بندي مرکب استفاده کنيم. براي مثال اگر ملاک دسته بندي نحوه بدنيا آوردن فرزندان و وجود شش ها باشد ما سه نوع کلاستر داريم که در شکل (ج) آورده شده است.


 اين مثال نشان مي دهد که فرايند نسبت دادن اشيا به کلاسترها ممکن است به نتايج بسيار متفاوتي منجر شود. کلاسترينگ يکي از ابتدايي ترين فعاليت هاي ذهني است که براي کنترل  کردن مقادير زياد اطلاعات دريافت شده هر روزي استفاده مي شود. پردازش هر بخش از اطلاعات به عنوان يک موجوديت تک امکان پذير نيست. بنابراين انسانها به دسته بندي موجوديت ها (حوادث، انسانها، اشيا و غيره ) در کلاسترها روي مي آورند. هر کلاستر توسط خصوصيات مشترک موجوديت هايي که درون آن قرار مي گيرند تعريف مي شود. کلاستر، يک مجموعه از داده هاست بطوريکه:

·        داده هاي موجود در يک کلاستر شبيه يکديگر هستند.

·        داده هاي موجود در کلاسترهاي مختلف به يکديگر شبيه نيستند.   

    انواع کلاسترها


کلاستر ها انواع مختلفي دارند که در به زير تعدادي از آنها اشاره شده است:

- كلاسترهاي بخوبي جدا شده 

مجموعه نقاط داخل اين كلاستر نسبت به نقاط خارج آن به يكديگر بسيار شبيهند. 

- كلاسترهاي مبتني به مركز:

مجموعه نقاط داخل اين كلاستر به مركز كلاستر نسبت به مراكز كلاسترهاي ديگر بسيار نزديكترند.

- كلاسترهاي مبتني بر مجاورت و نزديكي:

مجموعه نقاط داخل اين كلاستر به يك يا تعداد بيشتري از نقاط داخل كلاستر نسبت به نقاط خارج آن شبيهند.

  گامهاي اساسي در انجام کلاسترينگ:


به منظور ايجاد کلاستر ها (انجام عمل کلاسترينگ) اعمال زير بايد انجام شوند:

1.      انتخاب ويژگي: خصوصيات بايد به طور مناسبي انتخاب شوند تا اکثر اطلاعات را کدگذاري کنند.

2.      مقياس نزديکي: معياري است که ميزان شباهت و يا عدم شباهت دو بردار خصوصيت را مشخص مي کند. تمام خصوصيات انتخاب شده بايد در محاسبه اين معيار شرکت کنند و هيچ خصوصيتي نبايد بر بقيه غلبه کند. به عنوان مثال فاصله اقليدسي يا فاصله منهتن.

3.      ملاک دسته بندي: که در قسمتهاي بالا در مورد آن صحبت  شده است.

4.      الگوريتم کلاسترينگ: پس از اينکه ملاک دسته بندي و مقياس نزديکي انتخاب شدند در اين گام يک الگوريتم خاص جهت روشن کردن ساختار دسته بندي مجموعه داده انتخاب مي شود.

5.      اعتبار نتايج: زمانيکه نتايج کلاسترينگ بدست آمد بايد صحت و درستي آنها بررسي شوند. اين کار معمولا بوسيله تست هاي مناسبي انجام مي شود.


درمقاله بعدي از انواع الگوريتمهاي کلاسترينگ صحبت خواهيم کرد.

 منبع : http://www.30sharp.com


کلاسترینگ در ویندوز 2003

کلاسترینگ در ویندوز 2003

کلاسترینگ معنیش همون دسته بندی میشه.

با کلاسترینگ سرور ها میشه بارهای برروی یک سرور رو بین چندین سرور تقسیم کرد (NLB=Netwrok Load Balancing)
در صورت کلاستر کردن یک بالانس کلی بین سرور ها برقرار میشه.

این دسته بندی می تونه به روشهای متفاوتی انجام بشه.

مثلا" فکر کنید یک سایت دارید که هزاران نفر هر روز میان و به اون سر میزنن و ازاش بازدید میکنن و به همین خاطر بار زیادی رو سرورتون هست. شما می تونید با استفاده از چند سرور این بار رو بینشون تقسیم کنید. تنظیمات کلی دسته بندی سرورها رو انجام میدید و بعد از اون هر زمان که کاربرها به سرور شما میان هر دفعه کاربر به یک سرور مسیر داده میشه.
مثل round robin که در DNS هست.(هر دفعه dns یک ipدیگه رو بده)

نوع دیگر دسته بندی برای نرم افزارها و یا دیتابیس های تجاری هست.
شما یک شرکت بزرگ رو مدیریت میکنید و مثلا" نرم افزار و یا دیتابیس X همیشه باید آنلاین باشه و برنامه نویسها و یا کارمندان بخش حسابداریتون از اون دیتا استفاده کنن. شما باید چند سرور خریداری کنید یک هارد اشتراک بگذاریدو تنظیمات RAID و اتصالات دیگر رو روش انجام بدیدو بین سرورهاتون به اشتراک بگذارید.

حالا اگر یکی از سرور های شما ناگهان قطع بشه یا مشگلی پیش بیاد سریعا" سرور بعدی می تونه کار اون یکی سرور رو انجام بده.
این نوع کلاسترینگ یا دسته بندی رو Server Clusters میگن که فقط در ویندوز سرور 2003 ent و datacent فعال هست در صورتی که NLB در تمام نسخه های وین سرور فعال هست.

اگر دوست داشتیددرباره تنظیمات کلاسترها بدونید اون مقاله های آنلاین رو بخونید و به کتابهای مرجع ویندوز سرور مراجعه کنید تنظیمات زیادی داره.
به اینجا هم می تونید مراجعه کنید:
http://www.windowscluster.com

اگر می خواهید تنظیمات NLB رو ببینید می تونید به تنظیمات کارت شبکه خودتون مراجعه کنید و در اونجااز NLB یک properties بگیرید.

From its roots in the Wolfpack Project at Microsoft, clustering has matured into an
important part of any enterprise Windows implementation. This chapter examines
Microsoft’s latest cluster offerings and describes how they can be used to scale and
extend your Windows Server 2003 network.
Acluster can most easily be defined as a group of individual servers that work together
as a single system. Software and clients see the cluster as a single entity, and the cluster is
managed as a single unit. Clustering is used to ensure high availability for mission-critical
applications, manageability for 24/7 implementations, and scalability for large enterprise
solutions. Two clustering technologies are available in MicrosoftWindows Server 2003:

Network Load Balancing (NLB) Primarily intended to balance incoming
TCP/IP traffic. NLB is commonly used for web servers.

 Server Clusters Implemented to provide failover services among the clustered
computers. The Cluster service is commonly used for database applications.
You can’t use both on the same server, but you can use the two cluster solutions
together to gain complementary functions—for example, making a database
application available to web site visitors

درباره کلاسترینک سرور های ویندوز می تونید اینجا رو ببینید:

http://www.microsoft.com/windowsserv...m/default.mspx
اطلاعات بیشتر:
http://www.microsoft.com/windows2000...ustersteps.asp

مبحث طولانی هست!

در لینوکس هم اگر redhat دارین می تونید از :
Red Hat Cluster Suite

http://www.redhat.com/en_us/USA/home.../clustersuite
استفاده کنید.


استفاده از Thread ها در دلفی

استفاده از Thread ها در دلفی


اساس کار ویندوز در اجرای برنامه ها بر روی Thread ها است ، هنگامی که برنامه ای اجرا می شود ، کلیه کدها و فایلهای منبع ( Resource ) آن در یک یا چند Thread قرار می گیرند ، درواقع هرProcess در ویندوز دارای یک یا چند Thread است که اطلاعات Process درآنها قرار دارند و بر روی حافظه موقت بارگذاری شده اند ... ، برنامه ها میتوانند در زمان اجرای خود Thread هایی ساخته و سپس آنها را آزاد نمایند ، کار یک Process زمانی به پایان می رسد که تمام ، Thread های آزاد شده باشند ، در غیر این صورت آن Process بسته نخواهد شد ، پس باید در آزادسازی Thread ها دقت زیادی داشت ...

ساخت Thread و استفاده از آن در برنامه :
در دلفی کلاسی به نام TThread قرار دارد که امکان استفاده از Thread ها را فراهم می سازد ...
برای استفاده از یک Thread ابتدا باید یک نسخه از کلاس TThread را Create کرده و سپس از آن استفاده نمایید
برای ساخت یک Thread به صورت زیر عمل می کنیم :

کد:
Type
 MyThread = Class(TThread)
  private
    …
  protected
    ...
 end;

در کد بالا یک نوع از TThread را ساختیم ...
در یک Thread میتوانید Procedure ها و توابعی را قرار داده و از آنها استفاده نمایید ، توجه داشته باشید که برای فراخوانی توابع و متد ها باید از روش Synchronization ( همزمان سازی ) استفاده نمایید ، شاید با دیدن این کلمات احساس کنید که کار سختی در پیش دارید ، اما اصلا این طور نیست ، این کار با اجرای یک تابع ساده امکان پذیر است که در ادامه توضیح خواهیم داد ...
Thread ها یک Event اصلی به نام OnExecute دارند که مربوط به زمان اجرا شدن آنها است ، تمام کار Thread ها در همین Event انجام می شود ، کدی که در این رویداد می نویسید از زمان اجرا شدن Thread تا زمان Terminate شدن آن اجرا خواهد شد.
نمی توان در یک Thread به صورت مستقیم با اشیای فرم ارتباط داشت ، چنین درخواستهایی از Thread باعث متوقف شدن کار آن خواهد شد و نتیجه مطلوبی نخواهید گرفت ... ، برای دسترسی به اشیاء باید از Procedure های جدا و Synchronize استفاده نمایید تا اختلالی در کار Thread به وجود نیاید ...
ابتدا باید توابع و متد ها را در یک Thread تعریف کرده و کد مورد نظر را در آن بنویسیم ، سپس با تابع Synchronize به روش زیر می توانیم آن را اجرا نماییم :

کد:
Synchronize( My Procedure );

طریقه ایجاد توابع و Procedure ها در Thread مانند سایر کلاسها ( مثلا TForm ) است ، برای مثال فرض کنید متدی داریم که در آن عمل Progress کردن یک ProgressBar را انجام می دهیم ، میتوانیم به صورت زیر این متد را تعریف نماییم :

کد:
Type
 MyThread = Class(TThread)
  private
   procedure doProgress;
  end;

Implementation

procedure doProgress;
begin
  Form1.ProgressBar1.Progress;
end;

ساخت و استفاده از Thread :
در بالا نحوه تعریف یک Thread را توضیح دادیم ، برای استفاده از آن باید یک متغیر با نام Thread تعریف شده تعریف نماییم و از آن استفاده کنیم ...
نکته دیگر این که متد Create برای Thread ها یک پارامتر به نام Suspended دارد که از نوع Boolean می باشد و به صورت پیشفرض دارای مقدار False است ...
این پارامتر مشخص میکند که آیا Thread در حالت متوقف ساخته شود یا اینگه بعد از ساخته شدن بلافاصله در حالت اجرا قرار گیرد ( Thread بعد از ساخته شدن ، متد Execute اش اجرا خواهد شد ، با True کردن این پارامتر ، متد Execute را متوقف کرده و از اجرا شدن کدها جلوگیری می نماییم ) ، بعد از اجرای Thread ممکن است نیاز باشد که برخی از خصوصیات آن را تغییر دهیم ، پس باید به این پارامتر مقدار True دهیم تا Thread ما بعد از ساخته شدن در حالت اجرا نباشد و امکان تغییر خاصیتهای آن وجود داشته باشد ...
برای مثال بهتر است که خاصیت FreeOnTerminate مربوط به Thread ساخته شده را True نماییم تا هنگام فراخوانی متد Terminate برای پایان کار Thread‌ ، آن را آزاد کنیم ...
پس کد ما تا اینجا به شکل زیر درخواهد آمد :

کد:
var
 T : MyThread;
begin
 T := MyThread.Create(True);
 T.FreeOnTerminate := True;
 T.Resume;
end;

در کد بالا Thread ما ساخته شده و سپس خاصیت FreeOnTerminate آن True شده و سپس با استفاده از متد Resume به کار خود ادامه می دهد ( از حالت Suspend بیرون می آید ) ...

کد نویسی در رویداد OnExecute :
هر Thread ای که Create می کنید در حالت پیشفرض رویداد OnExecute را دارا می باشد ، برای این که آن را به دلخواه خود تغییر دهید باید آن را دوباره تعریف کنید ، برای تعریف این رویداد باید از قسمت Protection و وا‍ژه Override استفاده نمایید تا رویداد قبلی Thread از بین رفته و رویداد جدیدی که ایجاد می کنید جایگزین شود ، پس کد شما به این صورت خواهد بود :

کد:
type
 MyThread = Class(TThread)
  private
   ...  
  protected
   procedure Execute; override;
  end;

var

implementation

procedure MyThread.Execute;
begin

end;

اجرای Procedure های تعریف شده ( Synchronization ) :
برای فراخوانی Procedure هایی که تعریف کرده اید باید ار تابع Synchronize استفاده نمایید ( در داخل رویداد OnExecute ) ، برای مثال :

کد:
procedure MyThread.Execute;
begin
 Synchronize(doProgress);
end;

تابع Synchronize یک پارامتر دارد که از نوع TThreadMethod است و Procedure ای که در Thread تعریف کردید باید در آن قرار گیرد ...

مدیریت Thread :
برای استفاده از Thread با متدهای آن آشنایی داشته باشید ...
برای متوقف کردن یک Thread باید از متد Suspend استفاده نمایید ، و برای ادامه کار آن باید از متد Resume استفاده کنید :

کد:
MyThread.Suspend;
...
MyThread.Resume;

برای این که بفهمید آیا Thread ما در حالت Suspend است یا خیر میتوانید از خاصیت Suspended استفاده نمایید ، این خاصیت یک مقدار Boolean دارد که مشخص می کند Thread مورد نظر Suspend شده یا خیر :

کد:
var
 isSuspended : Boolean;
begin
 isSuspended := MyThread.Suspended;
end;

اگر می خواهید که کار یک Thread را کاملا متوقف نمایید ، می توانید از متد Stop استفاده کنید ، در این صورت برای اجرای دوباره Thread باید از متد Execute استفاده نمایید :

کد:
MyThread.Stop;
...
MyThread.Execute;

خاصیت Priority :
اگر در محیط ویندوز برنامه Task Manager را اجرا نموده و به قسمت Process بروید لیست Process های در حال اجرا را می بینید ، اگر بر روی هر کدام از این Process ها راست کلیک نمایید گزینه ای به نام Set Priority می بینید که مقادیری مثل High‌ ، Normal یا Low و ... دارد ، Priority مشخص می کند که در زمان الویت بندی اجرای Thread ها در CPU ، کدام یک ارجعیت دارند و به CPU ابتدا باید به درخواست کدام یک از آنها جواب دهد ، هرچه مقدار Priority یک Thread مقدار بالاتری داشته باشد ، الویت بیشتری خواهد داشت و عملیاتش زودتر انجام خواهد شد ...
می توانید برای Threadخود این خاصیت را تنظیم نمایید ، این خاصیت از نوع TThreadPriority می باشد ، در تصویر زیر مقادیری که می توانید به عنوان Priority قرار دهید مشخص شده است :


ThreadID :
این خاصیت شناسه ای برای Thread شما است که هم در زمان ساخت ( در زمان Debug‌ ) و هم در زمان اجرای برنامه می توانید از آن استفاده نمایید ، هنگامی که قصد Debug کردن برنامه خود در محیط دلفی را دارید ، پس از اجرا کردن برنامه اگر از منوی View گزینه Debug Windows و سپس گزینه Threads را انتخاب نمایید ، پنجره ای باز شده و لیستی از Thread های در حال اجرا در برنامه شما را نمایش میدهد که هرکدام از آنها دارای شناسه ای به نام ThreadID هستند ، با داشتن این مقدار می توانید Thread مورد نظر خود را در این پنجره پیدا نمایید ...
این مقدار را می توانید به روش زیر بدست آورید :

کد:
var
 MyThreadID : Cardinal;
begin
 MyThreadID := MyThread.ThreadID;
end;


خروج از Thread و آزاد کردن آن :
رویداد OnTerminate :
Thread یک رویداد دیگر دارد که میتوانید آن را مانند OnExecute تنظیم نمایید و تغییر دهید ، این رویداد زمانی اتفاق می افتد که Thread مورد نظر Terminate‌ شود ، اما متد دیگری به نام DoTerminate وجود دارد که این رویداد را اجرا میکند بدون اینکه Thread مورد نظر Terminate شود ( یا شده باشد ) ، با متد ...

---------

اگر یادتان باشد ،‌ ما در هنگام ساخت Thread مقدار خاصیت FreeOnTerminate‌آن را True کردیم پس اگر آن را Terminate نماییم ، آزاد ( Free ) خواهد شد ، با متد Terminate میتوانید به کار یک Thread پایان دهید :

کد:
MyThread.Terminate;

در برخی موارد ممکن است Thread مورد نظر Terminate نشود ! ، درواقع هنگامی که ما متد Terminate را اجرا می کنیم ، کار عمده ای انجام نمی شود ، بلکه فقط خاصیت Terminated مربوط به Thread بر روی True تنظیم می شود ! ، درواقع این عمل به Thread اعلام میکند که به زودی ممکن است کارش پایان یابد ، باید برای پایان کار Thread‌ ، بعد از اجرا این متد با استفاده از متد Exit ( مربـوط به Thread نیست ) از رویداد OnExecute خارج شد ( دستور Exit در دلفی برای خروج از یک رویه ( تابع یا ... ) به کار می رود ) :

کد:
procedure MyThread.Execute;
begin
 Synchronize(doProgress);
 …
 MyThread.Terminate;
 Exit;
end;

توجه داشته باشید که در قسمتهای مختلف کد باید چک کنید که آیا Terminated مربوط به Thread مقدار True دارد یا خیر و اگر مقدار True داشت با استفاده از دستور Exit از رویداد خارج شوید :

کد:
procedure MyThread.Execute;
begin
 if MyThread.Terminated then
    Exit;
 …
 if MyThread.Terminated then
    Exit;
 …
 MyThread.Terminate;
 Exit;
end;

علاوه بر موارد بالا می توانید از متد WaiteFor استفاده نمایید ، متد WaiteFor تا زمانی که کار Thread‌ به پایان برسد کارش تمام نخواهد شد ، درواقع می توانید کد Exit را بعد از این متد بنویسید تا خیالتان از بابت پایان کار Thread راحت شود ! :

کد:
procedure MyThread.Execute;
begin
 if MyThread.Terminated then
    Exit;
 …
 if MyThread.Terminated then
    Exit;
 …
 MyThread.Terminate;
 MyThread.WaiteFor;
 Exit;
end;


امیدوارم مفید بوده باشه ...

PDF این مقاله رو می تونید از اینجا دانلود کنید ...


منبع : http://barnamenevis.org/forum/showthread.php?t=79463


Multi threading در پیتون

Multi threading در پیتون

موضوع هایی که می خواهیم در موردشان بحث کنیم:

  • 1. مقدمه
  • 2. نخها و پروسس ها
  • 3. نخها و پیتون
  • 4. ماژول thread
  • 5. ماژول threading

در این موضوع , ما می خوایم راههایی که شما می توانید اجرای موازی و همزمان رو در کد خودتون استفاده کنید و چگونکی استفاده ازبرنامه نویسی Multithread (MT) و ایجاد آن در پیتون. این مقاله مثل تمام مقالات من کامل نیست و من فقط مطالبی که به نظر مهم هستند و به کمکتون می یاد را توضیح می دهم.

  • مقدمه:

قبل از هر چیز باید بدانید که برنامه نویسی چند نخی (Multithread) یکی از قابلیت هایی است که مستقیما به سیستم عامل مربوط می شود یعنی سیستم عامل شما باید از این شیوه پشتیبانی کند (سیستم عامل ویندوز این قابلیت را دارد). هر وقت برنامه ای شروع به اجرا می کند ویندوز یک ( نخ) به ان اختصاص می دهد این Thread در واقع رابط بین برنامه و CPU است . همونطور که می دانید CPU برای اینکه بتواند چند وظیفه را بصورت هم زمان انجام دهد , به هر Thread یک زمان مشخص اختصاص می دهد (با توجه به اولویت Thread). مثلا اگر ما دو Thread در حال اجرا داشته باشیم CPU یک زمان خاصی را به Thread اولی اختصاص می دهد تا کارش را انجام دهد پس از اتمام زمان نوبت به Thread بعدی می رسد و به همین ترتیب...

  • نخ ها و پروسس ها:
  • پروسس چیست:

برنامه های کامپیوتر صرفا اجرا پذیر هستند, باینری (یا طور دیگر ), این برنامه ها روی دیسک قرار دارند. اینها نمی توانند کاری انجام بدهند(به اصطلاح مرده هستند) تا زمانی که داخل حافظه بارگذاری شوند و از سیستم عامل درخواست کنند. پروسس یک برنامه در حال اجرا است. هر پروسس یک ادرس فضا , حافظه و یک پشته داده دارد. سیستم عامل کنترل کننده تمام پروسس های در حال اجرا بر روی سیستم است, و زمان رو میان انها به طور خوب تقسیم می کند. پروسس ها می توانند چند شاخه بشوند یا یک پروسس جدید برای انجام دیگر کارها ایجاد کنند, هر یک از این پروسس های جدید حافظه و پشته داده و... خودشان را دارند ولی نمی توانند به طور عمومی از اطلاعات سهمی داشته باشند مگر اینکه از IPC ها استفاده کنند.

  • نخ چیست:

Thread ها یا نخ ها به قطعه کدهایی گفته می شود که به صورت موازی و همزمان با هم اجرا می شوند و به شما این امکان را می دهند برنامه هایی را طراحی و پیاده سازی کنید که می توانند چندین کار را با هم انجام دهند به طور مثال : جستجوی چند فایل یا گرفتن اطلاعات از طریق شبکه و ذخیره انها در دیسک. البته اصولا نخ ها به صورت همزمان اجرا نمی شوند بلکه CPU براساس تنظیم زمان خود یک زمان غیر قابل درک برای انسان را در نظر می گیرد سپس در این مدت زمان یک کار را انجام داده و پس از اتمام این زمان به سراغ کار بعدی می رود به اصطلاح در کارهای خود سوییچ می کند. به این مدت زمان کوتاه اصطلاحا Time Slice یا پرش زمان می گویند.

  • نخ ها و پیتون:
  • دسترسی به نخها در پیتون:

پیتون از برنامه نویسی چندنخی پشتیبانی می کند. پس باید سیستم عامل در حال اچرا ان را پشتیبانی کند بیشتر ورژنهای Unix , Solaris , Linux و Windows از این قابلیت پشتیبانی می کنند و فکر کنم مکینتاش از این قابلیت برخوردار نیست.

  • ماژولهای نخ کشی پیتون:

پیتون چند ماژول برای پشتیبانی ازبرنامه نویسی MT شامل thread , threading و Queue را اماده دارد. ماژولهای thread و threading به برنامه نویس اجازه ساختن و اداره نخ را می دهند. ماژول thread برای کار با نخ به صورت ساده و پایه ای است ولی ماژول threading خصوصیات سطح بالا و کاملی از برنامه نویسی نخ در اختیار ما قرار می دهد. ماژول Queue به کاربر اجازه ساختن صف داده را می دهد. این ماژول در محدوده بحث ما نیست و شاید در مقاله دیگری در مورد ان بحث کردیم.

  • ماژول thread :

این ماژول همان طور که گفته شد امکانات کم و سطح پایینی برای کار با چندین نخ در اختیار ما قرار می دهد. تابع اصلی و کلیدی این ماژول start_new_thread() است این تابع خیلی به apply() شباهت دارد.من در اینجا ابتدا چند تا از متدهای این تابع را توضیح می دهم.

1.start_new_thread(function, args, kwargs = None)

شروع یک نخ جدید و عددی که مشخص کننده هویت ان است نخ با گرفتن یک لیست از ارگومانها (که باید در داخل tuple باشند) تابع را اجرا می کند.ارگومان kwargs اختیاری است که با دیکشنری از کلمات کلیدی ارگومانها مشخص می شود. وقتی تابع اجرا شد و بازگشتی ان مشخص شد نخ از کار می افتد.


2.interrupt_main()

ایجاد یک KeyboardInterrupt در نخ اصلی , یک subthread می تواند می تواند از وقفه ایجاد شده در نخ اصلی استفاده کند.

3.exit()

باعث اجرای استثنای SystemExit می شود. اگر نتوانست پیدا کند باعث توقف نخ می شود.

4.allocate_lock()

برگرداندن یک شی lock جدید . متدهای قفل ها در زیر امده اند.

5.get_ident()

عدد مشخص کننده هویت نخ در حال جاری را برمی گرداند این عدد یک عدد غیر صفر است. این اعداد که مشخص کننده هویت نخ هستند هیچ گاه بعد از استفاده نخ و خارج کردن ان دور انداخته نمی شوند و می توانند به نخ هایی که بعدا ایجاد می شوند نسبت داده شوند.(مثل استفاده از دایل اپ برای کانکت شدن به اینترنت که هر دفعه یک ای پی به ما داده می شود و بعد از قطع ارتباط این ای پی به شخص دیگری که به اینترنت وصل می شود داده می شود...)


[ویرایش] متدهای مطلق به شی Lock :

1.acguire([waitflag])

برای بدست اوردن و جستجوی lock های قطعی است.

2.locked()

اگر یک lock بدست اورد 1 در غیر این صورت نتیجه 0 است

3.release()

برای ازاد کردن lock


برای فهمیدن و درک چنین بحث هایی در برنامه نویسی باید خیلی تمرین کرد و مثال های مختلفی را تجزیه و تحلیل کرد. مثال پایین یک مثال خوب و ساده برای دیدن نتیجه کار بعضی از توابع و متدها است. زیاد هم سخت نیست کمی دقت کنید متوجه می شوید.


01    #Using thread and Locks
02
03    import thread
04    from time import sleep, time, ctime
05    loops = [4, 2]
06    def loop(nloop, nsec, lock):
07        print 'start loop', nloop, 'at:', ctime(time())
08        sleep(nsec)
09        print 'loop', nloop, 'done at:', ctime(time())
10        lock.release()
11    def main():
12        print 'starting threads…'
13        locks = []
14        nloops = range(len(loops))
15
16        for I in nloops:
17            lock = thread.allocate_lock()
18            lock.acquire()
19            locks.append(lock)
20       
21        for I in nloops: 
22            thread.start_new_thread(loop, \
23                (I, loops[i], locks[i])) 
24
25        for I in nloops:
26            while locks[i].locked(): pass
27
28        print 'all DONE at:', ctime(time())
29    
30    if __name__ == '__main__':
31        main()
32


  • ماژول threading :

اگر شما قادر به کار کردن با ماژول thread باشید و درکی از آن داشته باشید از این ماژول نیز می توانید بدون توضیح استفاده کنید البته این ماژول امکانات فراوانی دارد که در ماژول thread وجود ندارد ولی به هر حال یاد گیری آنها ساده است. چون توضیح این ماژول به طور کامل خیلی وقت می برد و باعث طولانی شدن مطالب و شاید سردرگمی شما شوند.

در حال تکمیل توسط pyth0n

منبع:

  • 1.راهنمای خود پیتون
  • 2.کتاب Core Python


پروژه ای در مورد گرید کامپیوتینگ

از  وبلاگ دانشجویان گروه کامپیوتر موسسه آموزش عالی سلمان

خلاصه شده از وبلاگ زیر

آدرس : http://salmancg.blogfa.com/cat-6.aspx

سلام، بالاخره تتونستم دو پروژه مربوط به گرید رو آپلود کنم و براتون بزارم. فایل اولی رو قبلا برا دوستان گذاشته بودمکه مربوط به درس شیوه ارائه بود. فایل دوم بطور دقیق تر معماری گرید رو مورد بررسی قرار میده.

فایل اول مربوط به آشنایی مقدماتی با تکنولوژی گرید هستش.

آشنایی با گرید [ 3 mb ]

فایل دوم مربوط به بررسی دقیق معماری گرید هستش، این فایل ترجمه Part دوم کتاب Introduction to Grid  از شرکت IBM هستش که کار ترجمه رو (به ترتیب حروف الفبا) من و خانم اسماعیل زاده و آقای بنائی و خانم طیرانی و آقای فاتحی انجام دادیم.

بررسی معماری گرید [ 8  mb]

اینجا از جمال عزیز برا پیگیریهاش و بیژن گل برا فعالیتاش در زمینه اطلاع رسانی، تشکر می کنم.

فایل ppt پروژه شیوه ارائه (Grid Technology)
دوستان عزیزم فایل PowerPoint ارائه ام که در مورد تکنولوژی گرید بود رو می تونید از لینک زیر دانلود کنید. امیدوارم براتون مفید باشه.

دریافت فایل Power Point

 از لینک زیر هم می تونید یه کتاب خیلی معتبر در زمینه Grid دانلود کنید. این کتاب از انتشارات شرکت IBM هستش.

دریافت Red Book


Clustering کردن Apache و MySQL

Clustering کردن Apache و MySQL

برای Clustering کردن، بستگی داره که شما در چه سطحی مایل به انجام این قضیه باشید. مثلاً میتونید یک نرم افزار رو Clustering کنید که برای این کار احتمالاً باید از Platform هایی مثل Java استفاده کنید که خود دارای امکانات Application Clustering هستند.
راه دیگه ای که داره توسط ما هم از اون استفاده میشه، Cluster کردن Apache و MySQL بر روی چندین سرور هست. برای این کار، باید DNS سروری داشته باشید که بر اساس Load سرور ها، IP های مختلف رو به کاربر در هنگام DNS Querry بده، بدین صورت کاربر شماره یک ، آدرس IP اول شما رو از DNS Server میگیره و کاربر شما دو هم آدرس شماره دوم رو و الی آخر

کاربر یک اتصال به سرور Apache شماره یک شما به IP مثلاً : xxx.xxx.xxx.1
کاربر دو اتصال به سرور Apache شماره دو شما به IP مثلاً : xxx.xxx.xxx.2
کاربر سه اتصال به سرور Apache شماره سه شما به IP مثلاً : xxx.xxx.xxx.3
....

حالا شما باید دارای چندین نسخه از سایتتون بر روی سرور های Apache تون باشید که برای این کار از نرم افزار های محتلفی برای Sync کردن اطلاعات می تونید استفاده کنید. در مورد MySQL یا SQL Server هم دقیقاً همین طور هست یعنی تعدادی سرور MySQL یا SQL هست که Cluster هستن. نرم افزار MySQL خودش از طریق MySQL Clustering از این امکان پشتیبانی می کنه، بنابر این شما می تونید تعداد نامحدودی سرور MySQL داشته باشید که Sync هستن و به صورت Cluster با هم کار می کنند.
این نوع کلاستر کاملاً Fail Safe هست، چرا که در صورت داون بودن هر کدم از سرور ها، سرور دیگری پاسخگوی کاربران خواهد بود.

منبع : وب سایت سرورز24
 

Are You Looking for a Grid Job

Are You Looking for a Grid Job?

distributed.jpgMy team is looking for some folks to join up and help us bring grid technology to our customers. Drop me a line!


منبع : http://gridgurus.typepad.com


All of Your Data in One Basket

All of Your Data in One Basket

disk_000000967564XSmall.jpg

I once worked with this person who wrote programs that only wrote to a single file. Once this program was put into the grid environment it would routinely create files that were hundreds of gigabytes in size.  Nobody considered this to be a problem because the space was available and the SAN not only supported files of that size, but also performed amazingly well considering the expectations. While this simplifies the code and data management, there are a number of reasons why this is not a good practice.

  • You don’t always need all of the output data at once. Moving a piece from the grid to your desktop for testing would not even be a consideration.
  • The amount of computation-time needed to recreate a huge file is significant.
  • There is no easy way to get to use multiple threads for writing and/or reading data.
  • Moving files across the network takes a lot more time.
  • A file can only be opened in read-write mode by one process at a time.  One large file is going to block a lot more modification operations than several single files.
  • Backing the file up is remarkably more difficult.  You cannot just burn it to a DVD so it has to be sent to disk or to tape.  If you need to restore a file it can take a significant amount of time.
  • Your file is going to be severely fragmented on the physical drives and therefore will cause increased seek times.
  • You can no longer use memory-mapped files.
  • Performing a checksum on a large file takes forever.
  • Finally, if you had properly distributed the job across the Grid, you should not have such large files!!!

Why would anybody do such a thing?  All your data are belong to us?

منبع : http://gridgurus.typepad.com


ابر رایانه

ابر رایانه


ابر رایانه وسیله ای برای تبدیل مسایل محاسبه ای به مسایل ورودی و خروجی است.
کن باچر (Ken Batcher)


ابر رایانه رایانه ای است که در زمان معرفی از نظر ظرفیت پردازش و به خصوص سرعت محاسبه ازدیگر ماشین ها قوی تر باشد. اولین ابر رایانه ها در دهه ی 1960به طور عمده در موسسه اطلاعات کنترل (CDC) توسط سیمور کری«Seymour Cray» طراحی شد. کری تا دهه ی 1970 زمانی که برای تاسیس شرکت خود پژوهشکده کری, از آن جدا شد آنرا هدایت می کرد. کری بعدها با طرح های جدید خود بازار ابر رایانه را در دست گرفت و تا 25 سال (1965 1990) بی رقیب ماند. در دهه ی 1980به موازات تولید یک دهه قبل تر کامپیوتر کوچک هاشمار زیادی از رقیبان کوچکتر وارد بازار شدند اما بسیاری از آنها در" رکود بازار ابر رایانه ها" ی اواسط دهه ی 1990 ناپدید شدند. امروزه ابر رایانه ها طرح های یک بار تولید شونده هستند که توسط شرکت های "سنتی" مانند IBM و HP طراحی می شوند. این شرکت ها بسیاری از شرکت های دهه ی 1980 را برای استفاده از تجاربشان خریداری کردند، هر چند در طراحی ابر رایانه ها موسسه ی کری متخصص تر است .


معنای کلمه ی ابر رایانه تا حدی متغیر است , و ابر رایانه های امروزی فردا دیگر کاربردی نخواهند داشت، همانگونه که از کولاسوس (Colossus)،‌ (اولین رایانه ی الکترونیکی برنامه دار رقمی دنیا، که طی جنگ جهانی دوم رمز های آلمانی ها را می شکست) پیدا است. ماشین های اولیه ی سی دی سی (CDC) صرفاً پردازنده های منفرد پر سرعتی بودند که تا ده برابر سریع تر از سریع ترین ماشین هایی که توسط دیگر شرکت ها معرفی شده بودند کار می کردند. در دهه ی 1970 بیشتر ابر رایانه ها برای استفاده از پردازنده ی برداری طراحی می شدند و بسیاری از بازیگر های تازه کار برای ورود به بازار پردازنده هایی از این نوع را با قیمت ارزان تر عرضه می کردند. در دهه های 1980و 1990 پردازنده های برداری جای خود را به سیستم های پردازش موازی فشرده با هزاران سی پی یو (CPU) ساده ای داد که برخی از آنها واحد های غیر مرسوم و برخی طرح های متداول و سنتی بودند. امروزه طرح های موازی بر پایه ی ریز پردازنده های RISC " غیر مرسوم" مانند PowerPC یا PA_RISC قرار دارند.

منبع : zorrieh


Recommended reading list for grid developers

Recommended reading list for grid developers

By: Ovais Khan

Edna Nerona in an IBM Developer Work article, recommends a list of reading material for grid developers and researchers. Some of the important links are being provided here, For rest see the actual article.

منبع : http://www.gridblog.com/comments.php?id=242_0_1_0_C


Grid Computing as a Managed Service

Grid Computing as a Managed Service

By: Ahmar Abbas

"Grid computing is the latest to join the bandwagon of managed services. It's a good way of avoiding an expensive infrastructure investment", writes Bob Violino in his article Grid Computing Comes Around in this edition of Global Services magazine.

This article focuses on grid computing as a managed service. “What differentiates grid managed services from straight hosting is that the entire technology substrate that enables grid computing [software, hardware, storage] has already been deployed by the service provider,” says Ahmar Abbas, MD, Grid Technology Partners, a consulting firm in Falls Church, Va. “The client needs to just focus on the application enablement so that it can utilize the grid infrastructure.” Also different is the concept of paying for CPU utilization rather than a monthly fee for hosting infrastructure.

منبع : http://www.gridblog.com/comments.php?id=240_0_1_0_C


Elastic Compute Cloud Amazon EC2

Elastic Compute Cloud (Amazon EC2)

By: Ahmar Abbas

A few weeks back I blogged about Amazon's Simple Storage Service (S3) and how it was gaining traction in the market.

Well, it turns out that Amazon has even greater ambitions than just providing loads of hosted and managed storage! Today they announced their Elastic Compute Cloud (Amazon EC2).
The key to the technology seems to be the Amazon Machine Image (AMI). Users can create AMI based on their particular application or system profile. These are uploaded to the S3 service and are brought on line when required.

I can see some immediate business continuity / disaster recovery applications. Though not quite sure how load balancing occurs across multiples AMI instances that are brought live as application servers.

Another great step by Amazon to turn is technology platform into a revenue generating engine!

منبع : http://www.gridblog.com/comments.php?id=239_0_1_0_C


Software shops get SaaS-y

Software shops get SaaS-y

By: Ahmar Abbas

Independent Software Vendors (ISVs) that venture into the SaaS world have taken on two distinct sets of responsibilities. First, like traditional software companies, SaaS vendors are responsible for continually delivering innovative and relevant software products. Second, SaaS vendors must also develop, manage and support the infrastructure that is used to provide the software to the end user, under a regime of demanding service level agreements and associated penalties. Here's a look at the challenges (and rewards) ahead.

Read full article in ITWorld

منبع :  http://www.gridblog.com/comments.php?id=238_0_1_0_C


Back to Grid Blogging - OGF, Airbus deal

Back to Grid Blogging - OGF, Airbus deal

By: Ovais Khan

Recently, I have been busy at work so stopped blogging for a while. During the period of inactivity, there had been numerous news items and grid related activities that I have been starring in my reader and mails. The following are highlights of this somewhat longer post.

  • EGA - GGF Merger
  • Airbus into Grid Computing
  • A good Computational Grid Intro


  • EGA - GGF Merger: EGA and GGF, the two mainstream standard groups which have been discussing about a merger for soem time now, have finally merged to form a new entity Open Grid Forum (OGF). OGF Website is still under construction and the Board of Directors and leadership teams are yet to be finalized.
    The Sci-Tech Today has the following comments:

    Mark Linesch, who will lead the group, said the OGF would "open new doors to scientific discovery, business value and commercial adoption worldwide."
    Experts welcomed the end of the groups' prolonged sparring over definitions and semantics.


    Instead of quoting more, I am providing a link of related resource for the interested readers:


  • Airbus into Grid Computing: Grid Today in a news story reports that Fujitsu Systems has received order from Airbus for SynfiniWay HPC Grid middleware

    SynfiniWay proved to have the most complete and integrated Grid computing solution for aerodynamics analyses at Airbus, combining service-oriented applications with open workflow capabilities for efficient support of complex dynamic processes.

    Fujitsu Systems Europe has also been contracted to develop the services around the aerodynamic applications, and to integrate SynfiniWay within the existing user desktop tools for transparent grid access.


  • A good Computational Grid Intro:
    I came across this well written state of affairs of Computational Grid by Tim Bray in his ongoing weblog.

منبع : http://www.gridblog.com/comments.php?id=236_0_1_0_C


Amazon Simple Storage Service - Gaining Momentum

Amazon Simple Storage Service - Gaining Momentum

By: Ahmar Abbas

What do Microsoft and SmugMug have in common? Both rely on the Amazon Simple Storage Service (S3) for cheap and reliable web-scale storage. With Amazon S3, growing companies now have the resources to look and feel like a Fortune 500 enterprise.

Today, Amazon announced a variety of customers that together are storing more than 800 million data objects using Amazon S3. On one end of the spectrum there is Microsoft, which is utilizing S3 to dramatically reduce its storage costs without compromising scale or reliability. On the other end are small businesses such as SmugMug that are depending on the S3 benefits of scale and cost-efficiently previously only available to large companies.

منبع : http://www.gridblog.com/comments.php?id=235_0_1_0_C


Four Reasons to Attend the Open Source Grid and Cluster Conference

conference_000003749151XSmall.jpgWe're combining the best of GlobusWorld, Grid Engine Workshop and Rocks-a-Palooza into one killer event in Oakland this May. Here's why you should come to the Open Source Grid and Cluster Conference:

  • Great Speakers: We're going to have the rock stars of the grid world speaking and teaching.

  • Great Topics: Dedicated tracks to each of the communities being hosted.

  • Community Interaction: The grid community is spread all over the world, this will be a meeting place to get face time with the people you know by name only.

  • You Can Speak: We're currently accepting agenda submissions for 90 minute panels and sessions.

This should be a fantastic conference, I'll look forward to meeting you there.

منبع : http://gridgurus.typepad.com
 

Grid vs Clouds? Who can tell the difference

Grid vs Clouds? Who can tell the difference?

clouds_000003876801XSmall.jpgThe term "cloud computing" seems to be attracting lots of attention these days. If you google it, you'll find more than half a million results, starting with Wikipedia definitions and news involving companies like Google, IBM, and Amazon. There is definitely no shortage of blogs and articles on the subject. While reading some of those, I've stumbled upon an excellent post by John Willis, in which he shares what he learned while researching the "clouds".

One interesting point from John's article that caught my eye was his regard of virtualization as the main distinguishing feature of "clouds" with respect to the "old Grid Computing" paradigm ("Virtualization is the secret sauce of a cloud."). While I do not disagree that virtualization software like Xen or VMware is an important part of today's commercial "cloud" providers, I also cannot help noticing that various aspects of virtualization were part of grid projects from their beginnings. For example, SAMGrid, one of the first data grid projects that served (and still serves!) several of Fermilab's High Energy Physics experiments since the late 1990's, allowed users to process data stored in multiple sites around the world without requiring users to know where the data will be coming from, and how will it be delivered to their jobs. In a sense, from physicist's perspective experiment data was coming out of the "data cloud". As another example, "Virtual Workspaces Service" has been part of the Globus Toolkit (as incubator project) for some time now. It allows an authorized grid client to deploy an environment described by the workspace metadata on a specified resource. Types of environments that can be deployed using this service range from atomic workspace to a cluster.

Although I disagree with John's view on the differences between the "old grid" and "new cloud" computing, I still highly recommend the above mentioned article, as well as his other posts on the same subject.

منبع : http://gridgurus.typepad.com


Interoperability of AG Toolkit 2.0 and inSORS Ig2.0 Confirmed

Interoperability of AG Toolkit 2.0 and inSORS Ig2.0 Confirmed

By: Mary E. Spada

CHICAGO, Nov. 17 -- After a period of focused testing, inSORS Integrated Communications and Argonne National Laboratory's Mathematics and Computer Science Division have confirmed the interoperability of AG Toolkit 2.0 and inSORS IG2.0. This development is critical to support the increasing demand for collaborative application tools, supporting group-to-group collaboration across the Grid, and incorporating multimedia large-format displays, presentation and interactive environments and interfaces to Grid middleware and to visualization environments. This technical milestone uniquely addresses the Grid community's interest in the open source framework of the AG Toolkit release, combined with priority commercial features such ease of use, application enhancements, and support packages. The user community stands ready to take advantage of this integration to support diverse collaboration requirements, including distributed meetings, lectures, and training. For example, the Access Grid (AG) is used. Dr. Jonathan C. Silverstein, Director of the Center for Clinical Information at the University of Chicago Hospitals, noted that the "compatibility of the inSORS AG solution with the Argonne open source Access Grid 2.0 software is outstanding news for the biomedical community. [Doctors] now have the benefits of both worlds: open source to expedite enhancements coupled with the turn-key commercial solution enabling the functionality to collaborate."

Another group active in the Access Grid community and an inSORS client has already implemented the interoperable package delivered by inSORS. The National Center for Atmospheric Research and the University Corporation for Atmospheric Research use the Access Grid technology as their primary collaboration tool. NCAR/UCAR deployed IG2.0 to several remote sites, including an inSORS custom Virtual Venue and bridging solution. NCAR/UCAR, working with inSORS and IG2.0, is dedicated to taking advantage of the AG Toolkit architecture while maintaining the specialized features provided by the inSORS software.

Michael Galich, CEO of inSORS, said, "Confirming the ability to plug the unique inSORS applications and services into AG 2.0 is exciting, and a complete win-win for all concerned." He noted that collaborative software is important to inSORS customers. "The AG 2.0 platform, united with the inSORS added feature set, creates a uniquely capable and scalable collaboration platform to build on for years to come," Galich said.

Some of the specialized inSORS features include improved audio and video applications, a data-sharing application-IGPix, an integrated text chat, remote control for cameras, an integrated scheduler, an integrated multicast-unicast bridge, interoperability with H323 devices and a record and playback application. These coupled with the new features of ANL's AG 2.0 release, which include data sharing and a generic framework for application integration, constitute a powerful collaboration suite.

Rick Stevens, director of the Mathematics and Computer Science Division at Argonne, said he was delighted that the commercial audience for the Access Grid can easily find the additional support and features they require from inSORS. He said, "Argonne is pleased to report another successful example of technology transferred to the private sector - particularly as the Access Grid represents another triumph for the viability of open source software."

منبع : http://www.gridblog.com/comments.php?id=191_0_1_0_M5


ثبت رکورد جدید انتقال اطلاعات با سرعت 16.4 ترابیت بر ثانیه

ثبت رکورد جدید انتقال اطلاعات با سرعت 16.4 ترابیت بر ثانیه

سرویس اخبار خارجی ایتنا - محققین برای این کار از 164 کانال مالتی‌پلکس که از روی طول موج دسته‌بندی شده و روی سرعت 100Gbps تنظیم گردیده بودند استفاده کردند.

خبر دستیابی محققین Alcatel-Lucent به رکورد جدیدی در ارسال اطلاعات بصورت نوری با استفاده از سه مدار فوتونی یکپارچه که در روز چهارشنبه همین هفته اعلام شد، امیدها را برای رسیدن به سرعت یکصد مگابیت بر ثانیه در شبکه‌های اترنت افزایش داد.

محققین Alcatel-Lucent در مقاله‌ای که در کنفرانس ارتباطات فیبر نوری و نمایشگاه/کنفرانس ملی مهندسی فیبر نوری (OFC/NFOEC) اعلام داشتند برابر تحقیقات انجام شده احتمالاً خواهند توانست به روش‌های مؤثری برای ارسال پرسرعت اطلاعات دست بیابند.

در بخشی از این مقاله آمده است: «فناوری‌های متعددی از جمله optoelectronic photoreceiver خطی و همچنین یک میکسر منسجم فوق سبک و مقاوم در برابر حرارت در این آزمایشات بکار گرفته شدند.»

ارسال موفقیت‌آمیز اطلاعات نوری توسط پژوهشگران آزمایشگاه‌های بل در Villarceaux فرانسه و با کمک آزمایشگاه‌های طالس 3 و 4 شرکت آلکاتل و همچنین شرکت Kylia که در زمینه ارائه راه‌حل‌های نوری فعالیت دارد، با سرعت 16.4 ترابیت بر ثانیه و در مسیری بطول 2550 کیلومتر صورت پذیرفت.

محققین برای این کار از 164 کانال مالتی‌پلکس که از روی طول موج دسته‌بندی شده و روی سرعت 100Gbps تنظیم گردیده بودند استفاده کردند.

منبع : http://www.itna.ir


بزرگ‌ترین ابرکامپیوتر اروپا ساخته می‌‌شود

بزرگ‌ترین ابرکامپیوتر اروپا ساخته می‌‌شود

انی که این ابرکامپیوتر تکمیل شود، سرعت اینترنت، سرعت انتقال اطلاعات و... در بریتانیا سریع‌تر از تمام کشورهای اروپایی خواهد شد.

دولت بریتانیا با کمک مالی 52 میلیون پوندی اعلام کرد که قصد دارد بزرگ‌ترین ابرکامپیوتر خود را بیش از پیش تقویت کند. زمانی که این ابرکامپیوتر تکمیل شود، سرعت اینترنت، سرعت انتقال اطلاعات و... در بریتانیا سریع‌تر از تمام کشورهای اروپایی خواهد شد.
بزرگ‌ترین ابرکامپیوتر بریتانیا که قرار است نام آن Terascale Resource یا Hector باشد به موسسه تحقیقاتی مجلس بریتانیا تعلق دارد.
این ابرکامپیوتر می‌تواند محاسبات مختلف از تغییرات آب و هوایی تا تشخیص ساختار اتمی را با سرعتی بسیار بالا انجام دهد.
بر اساس گزارشات منتشر شده، سرعت بزرگ‌ترین ابرکامپیوتر اروپا به 100 ترافلاپ می‌رسد و قادرست در هر ثانیه بیش از 100 تریلیون محاسبه را انجام دهد که این رقم 100 هزاربار سریع‌تر از سرعت محاسبه در کامپیوترهای معمولی است.
دولت بریتانیا بر این باور است كه راه‌اندازی بزرگ‌ترین ابرکامپیوتر این کشور می‌تواند به عنوان گام مهمی برای توسعه جامعه اطلاعاتی در این منطقه محسوب شود.
کشور بریتانیا در حال حاضر از دو ابرکامپیوتر استفاده می‌کند که در این میان کارشناسان پیش‌بینی می‌کنند با ساخت ابرکامپیوتر جدید، هردوی آنها برای همیشه بازنشست خواهند شد.
به گفته مسئولین، یکی از ابرکامپیوترهای کنونی بریتانیا که CSAR نام دارد و در دانشگاه منچستر به سر می‌برد ژوئن سال جاری برکنار می‌شود و این در حالی است که ابرکامپیوتر قدرتمندتر با نام HPCx که زیر نظر متخصصان دانشگاه ادینبورگ کار می‌کند تا دسامبر سال 2008 به فعالیت خود ادامه خواهد داد.
 

جگوار 54 هزار ميليارد محاسبه‌ي رياضي را در يك ثانيه انجام مي‌دهد

جگوار 54 هزار ميليارد محاسبه‌ي رياضي را در يك ثانيه انجام مي‌دهد

به گفته‌ي متخصصان رايانه، اين ابر رايانه پنجمين ابر رايانه‌ي قدرتمند جهان و مطمئنا سريع‌ترين دستگاه علم باز در آمريكا است، اين ابررايانه كه "جگوار" نام گرفته است؛ پيش از آن كه سرعت آن ارتقا داده شود، در رتبه‌ي سيزدهمين قدرتمندترين ابر رايانه‌هاي جهان قرار داشت.

هم اكنون قدرتمند‌ترين ابر رايانه‌ي جهان IBM Blue Gene است كه شش برابر جگوار سرعت عملكرد بيشتري دارد و مي‌تواند 324 هزار ميليارد محاسبه‌ي رياضي را در مدت يك ثانيه انجام دهد.


ابرکامپیوترها پرواز می‌کنند!

ابرکامپیوترها پرواز می‌کنند!

سازمان فضایی آمریکا(ناسا) قصد دارد با سرمایه‌گذاری فراوان یک ابرکامپیوتر را به فضا ارسال کند.

این مرکز با استفاده از چندین متخصص و کارشناسان قصد دارد ابرکامپیوتر مخصوص خود را هفتم آگوست به فضا پرتاب کند.
اقدامات ناسا برای سیم‌کشی‌های فضایی و راه‌اندازی شبکه‌های اطلاعاتی فضایی تاکنون خسارات سنگینی را به این سازمان وارد آورده است.
بر اساس گزارشات منتشر شده در نشریات تخصصی Aviation Week و Space Technology، ناسا قصد دارد تا پایان سال آینده یک ابرکامپیوتر دیگر را نیز از شرکت کامپیوتری IBM خریداری و آن را به فضا پرتاب کند.
هنوز اخباری در مورد قیمت ابرکامپیوترهای فضایی ناسا منتشر نشده است.
 

منبع : http://www.ict-khz.com


امارات ابركامپيوتر جديد ساخت

امارات ابركامپيوتر جديد ساخت

مركز آموزش و تحقيقات عالي امارات متحده عربي يك ابركامپيوتر جديد راه‌اندازي كرد.

اين ابركامپيوتر كه ساختار آن بر پايه سيستم Blue Gene ساخت IBM طراحي شده، قابليت تحقيق و پژوهش در منطقه را تا چندين برابر افزايش مي‌دهد.
صنايعي از قبيل نفت، گاز، بانكداري و ... مي‌توند از اين ابر كامپيوتر استفاده كنند. توان اين ابركامپيوتر محاسبه 7/5 ترابايت محاسبه در ثانيه است.


منبع : http://www.itna.ir


تسخير مرز تازه نانومتری در عالم تراشه ها

تسخير مرز تازه نانومتری در عالم تراشه ها

شرکت تراشه سازی اينتل اعلام کرده است که در آينده نزديک توليد انبوه پردازنده های مجهز به ترانزيستورهايی به قطر تنها 45 نانومتر (45 ميلياردم متر) را آغاز خواهد کرد.

هر چه مصالح اوليه ساختمانی ريزپردازنده کوچکتر باشد، سرعت و بازدهی آن بيشتر می شود.

شرکت کامپيوترسازی آی بی ام نيز گفته است که قصد توليد پردازنده ای با عناصر ريزتر از نسل فعلی را دارد.

"آی بی ام" که گاه از آن به عنوان "بيگ بلو" نيز ياد می شود و فناوری جديد را با شرکايش توشيبا، سونی و ای ام دی (AMD) توسعه داده، قصد دارد پردازنده های تازه را از سال 2008 در تراشه های خود جای دهد.

اما اينتل می گويد توليد تجاری پردازنده های تازه خود را از اواخر امسال در سه کارخانه آغاز خواهد کرد.

نشت الکتريکی

اين تحول بدان معنی است که "قانون" بنيادی مور همچنان اعتبار خود را حفظ می کند.

گوردون مور، از بنيانگذاران شرکت اينتل، در سال 1965 پيش بينی کرده بود که تعداد ترانزيستورهای روی يک تراشه (با مساحت ثابت) هر دو سال يکبار دو برابر خواهد شد.

پردازنده های تازه اينتل که "پنرين" (Penryn) نامگذاری شده است بيش از 400 ميليون ترانزيستور را روی تراشه ای که مساحت آن نصف يک تمبر باشد جای می دهد.

پنرين مانند پردازنده های فعلی به صورت دو هسته ای (dual-core) يا چهار هسته ای (quad-core) عرضه خواهد شد که بدان معنی است که روی هر تراشه دو يا چهار پردازنده جداگانه قرار خواهد داشت. اينتل سرعت پردازنده جديد را اعلام نکرده است.

توليد تکنولوژی 45-نانومتری از زمان ساخت ترانزيستور 65 نانومتبری هدف تراشه سازان بوده است.

فلزات جديد

ترانزيستور يک کليد ساده الکترونيکی است. هر تراشه نيازمند تعداد خاصی ترانزيستور است و هرچه تعداد آنها بيشتر باشد، تراشه می تواند محاسبات بيشتری انجام دهد.

تراشه سازان برای بيش از 45 سال موفق شده اند با کوچک کردن تدريجی ترانزيستورها و جای دادن تعداد بيشتر و بيشتری از آنها روی هر تراشه، پاياپای قانون مور حرکت کنند.

با اين حال با گذر از مرز 65 نانومتری، سيليکونی که برای ساختن عناصر اساسی اين کليدها - موسوم به نارساناهای دروازه ای (gate dialectric) - به کار گرفته می شد ديگر به آن خوبی عمل نمی کنند.

در نتيجه جريان الکتريکی گذرنده از ترانزيستور نشت کرده و بازدهی تراشه را کم می کند.

برای جلوگيری از اين وضع، پژوهشگران مجبور به ساختن ماده تازه ای شده اند که بتواند جريان های الکتريکی در چنين ابعاد کوچکی را مهار کند. دسته تازه ای که جايگزين سيليکون شده است فلزات high-k نام دارد.

'بزرگترين تغيير'

گوردون مور توسعه و گنجاندن اين مواد به عنوان عناصر تراشه را "بزرگترين تغيير در فناوری ترانزيستور" از اواخر دهه 1960 توصيف کرده است.

نخستين تراشه های حاوی وسايل 45 نانومتری را شرکت اينتل اواخر سال گذشته به نمايش گذاشت، اما آنها هنوز در محصولات تجاری جای داده نشده بودند.

دکتر تزشيانگ چن، معاون علوم و تکنولوژی در مرکز تحقيقات آی بی ام گفت: "صنعت تراشه سازی تاکنون با يک مانع عمده برای جلو بردن تکنولوژی امروزی روبرو بود.... اما بعد از حدودا 10 سال تلاش، اکنون راهی به جلو يافته ايم."

شيوه دقيق ساخت فلزات high-k توسط اينتل و آی بی ام فاش نشده است اما نکته مهم آنکه هر دو شرکت گفته اند که می توان آن را با کمترين زحمت در فناوری محصولات فعلی جای داد.

منبع : http://www.ict-khz.com